أخبار الذكاء الاصطناعي لتوليد الصور والفيديو — 2026-09-28
أغلقت OpenAI خدمة Sora (التطبيق وواجهة API) في 2026-09-24، ما بدأ إعادة ترتيب لاعبي الفيديو المغلقين، بينما تأكد بشكل مستقل عبر أربع منصات أن Qwen-Image-2.1 الخفيف بحجم 7B وMinimax H3 هما أقوى المرشحين بين النماذج المفتوحة.
ملخص أخبار الذكاء الاصطناعي لتوليد الصور والفيديو — 2026-09-28
يا جماعة، آسف على الانتظار! عالم توليد الصور والفيديو بالذكاء الاصطناعي تحرّك بجنون هذا الأسبوع، فإليكم التقرير 🔥🔥 أكبر خبر هو أن OpenAI أوقفت Sora (التطبيق وواجهة API معًا) في 2026-09-24، وكأن سؤال «هل يمكن أن تكون نماذج الفيديو مربحة؟» ظهر أخيرًا إلى العلن. في المقابل، خطف معسكر المصادر المفتوحة الأضواء تمامًا عبر Qwen-Image-2.1 من Alibaba (مجرد 7B لكنه يقترب بسرعة من النماذج المغلقة الضخمة 🐉) وMinimax H3، وحماس المجتمع لهما أعلى حتى من الحماس للمعسكر المغلق. لكن ليس كل شبكات التواصل في المزاج نفسه: الأماكن التقنية مثل r/StableDiffusion ومجتمع stable_diffusion على Lemmy ومستخدمي ComfyUI على YouTube منشغلون بمقارنات أدوات جادة، بينما تنتشر في المنصات العامة مثل المنتديات الفرعية الكبرى في Reddit وPinterest مشاعر عدم الثقة من نوع «أليست هذه الصور المولدة بالذكاء الاصطناعي مبالغًا فيها؟». وهذا أهم اكتشاف في هذه الجولة 🙌 أما X فكانت، بشكل غير متوقع، بلا نتائج تقريبًا هذه المرة (والسبب لاحقًا).
عبر المنصات
ملاحظات من جانب المصادر المغلقة (13 نقطة كاملة 📸)
- أوقفت OpenAI خدمة Sora بالكامل، التطبيق وواجهة API للمطورين، اعتبارًا من 2026-09-24. ويُقال إن الانسحاب كان ملحًا للغاية — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- التفسير الأرجح للإغلاق هو أن اقتصاديات الوحدة في توليد الفيديو كانت سيئة جدًا — Bluesky https://bsky.app/profile/richargh.de/post/3mhur4qo3vc2x
- هناك تقارير أيضًا بأن Wan 3.0 من Alibaba تجاوز Sora في تصنيفات نماذج الفيديو — YouTube https://www.youtube.com/watch?v=5Hb429VYNUU
- وصل GPT Image 2.5 مع وضعي Flare (للسرعة) وSunburst (للتفاصيل)، وخفّض زمن الاستجابة إلى النصف ورفع دقة الالتزام بالصور المرجعية — YouTube https://www.youtube.com/watch?v=QOfLgJ3TCrQ
- أضاف Midjourney معاينة مباشرة للأسلوب في نسخة ألفا، ويواصل التحديث بهدوء شهريًا من V8 إلى V8.1 ثم V8.2 — Bluesky https://gen-ai.news/stories/edit-updates-thumbnail-previews-and-more-20d5ed / YouTube https://www.youtube.com/watch?v=dvfH5HzCARY
- دمجت Adobe Photoshop وLightroom وFirefly وAcrobat بحيث يمكن استخدامها مباشرة من محادثات Gemini وClaude — Bluesky https://gen-ai.news/stories/adobe-expands-its-ai-integrations-to-gemini-plus-further-powers-up-with-claude-6737b7
- أكملت Adobe الاستحواذ على Topaz Labs، مع دمج مبكر لتقنيات رفع الدقة بالذكاء الاصطناعي في Firefly وPhotoshop — Bluesky https://gen-ai.news/stories/adobe-s-acquisition-of-topaz-labs-is-complete-as-double-down-on-ai-enhancements--3c3f96
- استحوذت OpenAI على شركة معالجة الصور الناشئة Glass Imaging مقابل 300 مليون دولار، مستهدفة سلسلة العمل من الالتقاط إلى التوليد — Bluesky https://gen-ai.news/stories/openai-reportedly-buys-photo-processing-company-glass-imaging-for-300-million-e004d2
- منصة «Dramagic» من ByteDance هي خط إنتاج كامل يولّد 95% من الدراما القصيرة الصينية بالذكاء الاصطناعي من دون طاقم بشري — Bluesky https://gen-ai.news/stories/bytedance-launches-dramagic-a-full-pipeline-ai-platform-for-producing-short-dram-20f217
- تعمل Runway على نموذجي العالم الفوريين GWM-1/GWM-2 اللذين يفهمان البيئة باستمرار بدلًا من مجرد توليد مقاطع منفصلة — Bluesky https://gen-ai.news/stories/runway-s-worldprompt-and-the-engineering-of-real-time-worlds-80e2b7
- يدعم Veo3، عبر Gemini API، توليدًا سريعًا من الصورة إلى الفيديو مع صوت أصلي، وتُنتج مواد دعائية بكثافة على Pinterest أيضًا — Pinterest https://www.pinterest.com/pin/871728071631063018/
- انتشر أيضًا فيديو مقارنة مباشرة وجادة بين Kling 3.0 وGrok Imagine وRunway Gen-4.5 وVeo 3.1 — YouTube https://www.youtube.com/watch?v=x5fMQvhKP60
- يميل الجمهور العام إلى استهلاك صور وفيديوهات الذكاء الاصطناعي المغلقة بوصفها «فضائح»: غضب من صور عقارات محسّنة بالذكاء الاصطناعي (27,008 نقطة) — Reddit https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ ، وفصل مدير تنفيذي بسبب صورة مولدة بالذكاء الاصطناعي (594 نقطة) — Reddit https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/ ، وتأييد واسع لقانون إلزام العلامات المائية للذكاء الاصطناعي (13,925 تعليقًا) — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
ملاحظات من جانب المصادر المفتوحة (12 نقطة أخرى 🛠️)
- أطلقت Alibaba نموذج Qwen-Image-2.1 المفتوح الأوزان والخفيف بحجم 7B، ويدمج التوليد والتحرير ويدعم الطبقات الشفافة وما يصل إلى 10 صور مرجعية — Bluesky https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r ،Lemmy https://lemmy.dbzer0.com/post/75874773 ،YouTube https://www.youtube.com/watch?v=3qGl0wiv2G0
- بل إن هناك ادعاءات بأن Qwen-Image-2.1 يتفوق في بعض المهام على نموذج Google المغلق الضخم «Nano Banana 2.0» — YouTube https://www.youtube.com/watch?v=fwHS0ubmI7I
- انتقل مركز الاهتمام لدى مجتمع r/StableDiffusion من Z-Image Turbo إلى Krea 2 — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- تتوالى إصدارات LoRA لتسريع Krea2، مثل Turbo-Distill وinpaint-edit، على Lemmy — Lemmy https://lemmy.dbzer0.com (مجتمع stable_diffusion)
- أصبح Minimax H3 ساحة العمل الرئيسية للفيديو المفتوح، مع تكاثر أدوات محيطة أسبوعيًا مثل AutoContext وواجهة تحكم كاميرا ثلاثية الأبعاد وعقد تحرير الخط الزمني وLoRA باسم TaoMate-H3 — Lemmy https://lemmy.dbzer0.com/post/75586069
- أُطلق SenseNova-U1.5 بترخيص Apache-2.0، وهو مدمج بالفعل في ComfyUI — Reddit r/StableDiffusion (الموضوع 11)
- ظهر LTX-2.5 كنموذج فيديو سريع مفتوح الأوزان، ينافس MiniMax H3 وSeedance 2.5 في السرعة — YouTube https://www.youtube.com/watch?v=qVGpyw-F-rw
- يتاح Wan 3.0 حاليًا عبر API وبيتا عامة فقط، ولم تُنشر أوزانه المفتوحة بعد (بينما سلسلة Wan2.x القديمة مفتوحة)، وتراهن Alibaba على المسارين المفتوح والمغلق معًا — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
- أصبح SupraLabs/Supra2-IMG، وهو نموذج text-to-image خفيف للغاية من 100 مليون معامل فقط، حديث الناس لجودته المتقدمة نسبة إلى حجمه — Lemmy https://lemmy.dbzer0.com/post/75874769
- ظهر well9472/Nanosaur2-670M، نموذج DiT مخصص للرسوم التوضيحية بتكلفة تدريب لا تتجاوز 600 دولار — Lemmy https://lemmy.dbzer0.com/post/76110122
- خضعت AI Horde، خدمة توليد الصور المجانية والموزعة، لتجديد شامل بواجهة وخلفية جديدتين — Lemmy https://lemmy.dbzer0.com/post/75736717
- قُدّمت «Amuse 3.0» من Stability AI، أداة لتوليد الصور محليًا برعاية AMD، على Pinterest أيضًا — Pinterest https://www.pinterest.com/pin/4601060441986715264/
توصلت Reddit وLemmy وBluesky وYouTube بصورة مستقلة إلى النتيجة نفسها: Qwen-Image-2.1 وMinimax H3 هما أقوى النماذج المفتوحة حاليًا، وهذا يرفع مستوى الثقة كثيرًا 🙆
منصة بمنصة
Reddit: لم يعثر البحث باستخدام عبارة واحدة إلا على 12 موضوعًا، لكن الجودة كانت عالية. في النقاش التقني داخل r/StableDiffusion، ذُكرت Krea 2 وQwen-Image 2.1 وMinimax H3 بالاسم بوصفها الرابحين الأحدث، بينما حققت قصص فضائح «الذكاء الاصطناعي بالغ في الصورة» أو «الذكاء الاصطناعي كذب» على المنتديات العامة الكبيرة مثل r/mildlyinfuriating وr/CriticalState انتشارًا أكبر بكثير، من آلاف النقاط إلى أكثر من عشرة آلاف. بلغ أعلى موضوع تقني 13 نقطة فقط، مقابل 1,104 نقطة لشبهة الغش في Nikon Small World؛ ويعبّر هذا الفارق في التفاعل مباشرة عن اختلاف استقبال المصادر المفتوحة والمغلقة.
X: لم تحقق هذه الجولة شيئًا تقريبًا من حيث الموضوع 😅 تم تحديد الموقع الجغرافي لمصدر اتصال الجلسة على أنه كرواتيا، لذا بُحثت كلمات Explore الرائجة كما هي: العملات المشفرة، ورسائل السحب المزعجة، ومعجبو F1، وجدالات تاريخ يوغوسلافيا السابقة، وصور السياحة، وتايلور سويفت. ونتيجة لذلك، لم تتضمن أي من 40 منشورًا كلمات «AI» أو «توليد صور» أو «توليد فيديو». تحقق هدف العدد، 20 منشورًا، لكن نسبة الصلة بالموضوع كانت 0%.
YouTube: غطّت 11 مراجعة فيديو الإصدارات الرئيسية مثل GPT Image 2.5 وQwen-Image-2.1 وLTX-2.5 وWan 3.0. تميل فيديوهات المصادر المفتوحة إلى إعدادات ComfyUI التي تختبر مدى سرعة تشغيل النموذج على بطاقة GPU الخاصة بالمستخدم، في حين استقرّت في المصادر المغلقة صيغ المتابعة الدورية مثل فيديوهات تحديث Midjourney الشهرية. لكن لم يمكن جلب معظم أعداد المشاهدات وأسماء القنوات، ولذلك تعذّر قياس حجم الاهتمام نفسه.
Bluesky: كان حساب الأخبار الآلي gen-ai.news محور مصادر المعلومات في هذه الجولة، وكانت كثافة أخبار المصادر المغلقة مرتفعة جدًا؛ إذ أعلنت Runway وAdobe وMidjourney وOpenAI وMeta وByteDance شيئًا تقريبًا كل يوم. كان منشور إغلاق Sora، بـ3,571 إعجابًا، أكبر انتشار في هذه المرحلة. أما في الجانب المفتوح، فباستثناء Qwen-Image-2.1 الذي حصل على 82 إعجابًا، تركزت المنشورات على منشورات قديمة من النصف الأول من 2025، ولم يُعثر تقريبًا على منشورات شخصية حديثة حول Wan أوLTX.
Lemmy: يُعد !«メールアドレス» المركز الفعلي الوحيد، وهو أشبه بقائمة روابط جديدة من GitHub/HuggingFace؛ إذ تصل تحديثات أدوات ComfyUI حول Qwen-Image-2.1 وMinimax H3 يوميًا تقريبًا. لا توجد مجتمعات مخصصة للمصادر المغلقة؛ فتصل قصص الجدل، مثل تعديل Stanford للعرق أو صور الأقمار الصناعية المزيفة في Google Earth أو إعلانات تطبيقات nudify من Meta، كمنشورات منفصلة إلى مجتمعات عامة مثل technology وnottheonion وdcstudios.
Pinterest: مساحة بصرية متخصصة لا تتوفر فيها أرقام التفاعل. من بين 50 دبوسًا جُمعت، احتكرت تقريبًا الصور المصغّرة ذات شعارات العلامات التجارية للنماذج المغلقة، مثل Veo3 وKling AI وLuma Dream Machine وGemini Omni. ولم يظهر سوى مثال واحد لـStability AI بين الصور التي تتناول المصادر المفتوحة مثل ComfyUI وLoRA ونماذج OSS الصينية. كما أن الرسوم المعلوماتية عن «كيف تميّز بين المحتوى المولّد بالذكاء الاصطناعي والحقيقي» تشكل فئة مستقلة، وهذا من خصوصيات Pinterest.
ما ينبغي متابعته
- اتساع تطبيق Qwen-Image-2.1 في ComfyUI — Lemmy https://lemmy.dbzer0.com/post/75874773
- وتيرة تكاثر الأدوات المحيطة بـMinimax H3، مثل AutoContext وTaoMate-H3 LoRA — Lemmy https://lemmy.dbzer0.com/post/75586069
- خريطة القوى في توليد الفيديو بعد إغلاق Sora، مع تجمّع المنافسة حول Veo/Kling/Grok/Runway/Seedance — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- اتساع التأييد لقوانين العلامات المائية الإلزامية للذكاء الاصطناعي — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
- ما إذا كانت Krea 2 ستنتزع الصدارة بالكامل من Z-Image Turbo — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- ما إذا كان Wan 3.0 سيتجه إلى نشر الأوزان المفتوحة أم سيواصل المسار المغلق — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
التوصيات
- راقب أسبوعيًا منظومة ComfyUI حول Qwen-Image-2.1 وMinimax H3، لأن عدة منصات أكدت بصورة مستقلة أنهما أقوى النماذج المفتوحة حاليًا.
- في الجولة القادمة من جمع بيانات X، لا تعتمد على الاتجاهات المحلية، بل أعد البحث بكلمات إنجليزية ويابانية تستهدف الموضوع مباشرة مثل «image generation AI» و«Stable Diffusion» و«Midjourney».
- تابع منافسة التسعير والميزات بين لاعبي الفيديو المغلقين بعد Sora، مثل Veo وKling وGrok وRunway وSeedance، إذ يخضع السوق لتقليص وإعادة ترتيب.
- تعامل مع Pinterest كمرجع بصري لمعرفة اللغة البصرية المستخدمة حاليًا، لا كوسيلة لقياس الاتجاهات، لغياب مؤشرات حجم الاهتمام مثل الحفظ والإعجابات.
- استمر في مراقبة اتساع عدم الثقة بالمحتوى المولّد بالذكاء الاصطناعي، المشترك بين Reddit وLemmy وPinterest، لأنه يرتبط مباشرة بمزاج التنظيم، ومنها إلزام العلامات المائية.
- عند إعادة جمع بيانات Reddit، استخدم كلمات بحث مخصصة لكل من «open source» و«closed source» لزيادة العدد نحو معيار إتمام الموجز، وهو تحليل 20 عنصرًا لكل منصة.
جودة البيانات
كان جمع بيانات X فشلًا عمليًا: أدى خطأ تحديد الموقع الجغرافي والاعتماد على كلمات الاتجاهات إلى صفر منشورات ذات صلة من أصل 40. لم تعمل واجهة البحث الرسمية في Bluesky بسبب خطأ 403، فانحازت البيانات إلى مقالات حساب gen-ai.news واحد. لا تتضمن بيانات Pinterest مؤشرات تفاعل كالحفظ والإعجاب، لذا لا يمكن قياس الشعبية؛ كما لم تتوفر أعداد المشاهدات وأسماء القنوات لمعظم بيانات YouTube. وتتركز معلومات المصادر المفتوحة في Lemmy فعليًا في مجتمع واحد ومنشور أو منشورين، كما بقي Reddit عند 12 موضوعًا فقط باستخدام عبارة بحث واحدة، أي دون معيار الإتمام البالغ 20.
ملخص حسب المنصة
Reddit — أخبار الذكاء الاصطناعي لتوليد الصور والفيديو
أين
جُمعت 12 سلسلة من 9 منتديات فرعية، وكلها ظهرت عبر بحث واحد: "Image and Video Generation AI News".
| المنتدى الفرعي | الأعضاء | السلاسل المجمعة |
|---|---|---|
| r/generativeAI | 157,870 | 3 |
| r/labrats | 726,970 | 2 |
| r/WhitePeopleTwitter | 3,145,768 | 1 |
| r/mildlyinfuriating | 12,600,570 | 1 |
| r/CriticalState | 43,691 | 1 |
| r/aivideomaking | 7,949 | 1 |
| r/ChaiUnofficial | 30,105 | 1 |
| r/StableDiffusion | 1,026,206 | 1 |
| r/AmItheAsshole | 24,612,930 | 1 |
يُعد r/generativeAI المركز المتكرر الوحيد للحديث عن توصيات الأدوات. أما البقية فهي ظهورات منفردة، معظمها منتديات ضخمة للجمهور العام مثل r/mildlyinfuriating وr/AmItheAsshole وr/WhitePeopleTwitter تتفاعل مع محتوى مولد بالذكاء الاصطناعي بدلًا من مناقشة التقنية، إلى جانب r/labrats التي حملت فضيحة واحدة عبر سلسلتين.
ما الذي يقوله الناس
- السلسلة 1 (r/generativeAI، 10 نقاط، 2026-09-23) — عن إنتاج فيديو طويل بالذكاء الاصطناعي: يشرح u/kaboom-o خط العمل الحقيقي حاليًا: «تتحول النصوص إلى قائمة لقطات، ثم إلى كومة من المقاطع من 5 إلى 15 ثانية، ثم إلى مونتاج... بالنسبة للمقاطع التي تحتاج إلى تثبيت الوجه مدة أطول، Seedance 2.5 (حتى نحو 30 ثانية، مع صوت أصلي)... مسودات حركة رخيصة... Grok Imagine Video بدقة 480p ولمدة 5 ثوانٍ. واللقطات الواقعية الجيدة: Gemini Omni Flash.» — https://www.reddit.com/r/generativeAI/comments/1wog53q/
- السلسلة 1 — يوضح u/AlfieSchmalfie التكلفة الحقيقية لقطعة مكتملة: «أنهيت للتو فيديو مدته 12 دقيقة. 148 لقطة... 8 أسابيع من التحرير. ميزانية تقارب 1,000 دولار أسترالي باستثناء اشتراكات Runway وElevenLabs... لكنه كان يستحق ذلك.»
- السلسلتان 2 و4 (r/labrats، 1,104 نقاط / 134 تعليقًا و419 نقطة / 90 تعليقًا، 2026-09-23/24) — فاز فيديو مجهر مولد بالذكاء الاصطناعي في مسابقة Nikon Small World in Motion؛ وأقرت Nikon باستخدام الذكاء الاصطناعي لـ«تحسينه» وإضافة ألوان زائفة. كتب u/Barkinsons (630 تصويتًا إيجابيًا): «لا مكان لأدوات الذكاء الاصطناعي في صور المجهر العلمي، لأن علينا التزام إعادة إنتاج صورنا بأقصى قدر من الصدق.» واعترف المؤلف لاحقًا بأن «ذكاءً اصطناعيًا غير خاضع للإشراف استُخدم لتقسيم وتسمية» هياكل لم يُتحقق أبدًا من أنها حقيقية؛ وكتب u/Feline_Diabetes (301): «إنه مضلل تمامًا... ينبغي أن تكون الصور حقيقية إلى حد كبير، معالجة بالطبع، لكن ليست رسومًا مولدة بالذكاء الاصطناعي.» — https://www.reddit.com/r/labrats/comments/1wo0j5e/ and https://www.reddit.com/r/labrats/comments/1woxdhk/
- السلسلة 3 (r/generativeAI، 3 نقاط، 2026-09-26) — أُحيل شخص يريد توليد صور مجانيًا إلى خيارات محلية ومجانية: أوصى u/Scuzzy_Womack بـ«Comfy ui غير المتصل بالإنترنت والمجاني»، فيما اقترح آخرون Yodayo/MoescapeAI وLeonardo بسبب أرصدتها اليومية المجانية. — https://www.reddit.com/r/generativeAI/comments/1wqfleb/
- السلسلة 5 (r/generativeAI، 5 نقاط، 2026-09-22) — عن مولدات الفيديو، يشير u/sharktank123456 إلى تحول في المنصة: «Dream Machine لم تعد متاحة للمشتركين الجدد لكن Luma Agents متاحة... منصة شاملة كاملة بكل النماذج الرئيسية.» ويشير u/jmbirn إلى خدمات التجميع مثل Magnific AI وFal وKrea بوصفها طريقة عملية لتجربة نماذج كثيرة عبر حساب واحد. — https://www.reddit.com/r/generativeAI/comments/1wngj3w/
- السلسلة 6 (r/WhitePeopleTwitter، 594 نقطة، 2026-09-25) — فُصل مدير تنفيذي لاتحاد ائتماني بسبب صورة مولدة بالذكاء الاصطناعي بعنوان «Lake America sweaters»؛ وكتب أعلى تعليق، u/samanime (298): «لو تحمّل مزيد من الحمقى كهذا عواقب مماثلة، لكان عددهم أقل بكثير.» — https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/
- السلسلة 7 (r/mildlyinfuriating، 27,008 نقاط، 723 تعليقًا، 2026-09-21) — إحباط من صور العقارات «المرتبة» بالذكاء الاصطناعي: «أريد فقط أن أرى المنزل كما هو الآن من دون الحاجة إلى تحليل ما هو حقيقي وما ليس حقيقيًا... فهو قد يزيل المشعات مثلًا، وبالتالي لن تتمكن فعليًا من ترتيب المكان كما يظهر.» ويشير أعلى تعليق من u/slothboy، بـ5,794 نقطة، إلى أن الحمام الذي أضافه الذكاء الاصطناعي سيكون «مشروعًا من خمسة أرقام» لبنائه فعليًا. — https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/
- السلسلة 8 (r/CriticalState، 1,314 نقطة، 13,925 تعليقًا، 2026-09-21) — يحقق «اقتراح قانون» على هيئة استطلاع لإلزام وضع علامات مائية على كل الصور والنصوص المولدة بالذكاء الاصطناعي تفاعلًا هائلًا؛ وأعلى التعليقات أصوات قصيرة من نوع «نعم ✅» تستشهد بمخاطر التضليل وحماية كبار السن من الاحتيال، مثل u/Middle_Juggernaut298: «بسبب تعرّض كبار السن للاحتيال أو ما شابه.» — https://www.reddit.com/r/CriticalState/comments/1wmktek/
- السلسلة 9 (r/aivideomaking، 13 نقطة، 2026-09-23) — حول توليد المطالبات لفيديو الذكاء الاصطناعي، يقول u/3DisMzAnoMalEE: «بعد بضع مئات من المطالبات وضبط البوابات وcfg والمطالبات السلبية خصوصًا، كان Grok الأفضل بفارق كبير... سواء للمحتوى الآمن أو NSFW من الصعب تجاوزه.» — https://www.reddit.com/r/aivideomaking/comments/1wo38ww/
- السلسلة 11 (r/StableDiffusion، نقطة واحدة، 2026-09-25) — أكثر عرض تقني للمصادر المفتوحة في المجموعة: الإجماع هو أن المجال انتقل للتو من Z-Image Turbo إلى Krea 2 في تحويل النص إلى صورة («بدلًا من z image أصبح الآن kre2... Krea2 تفعل كل ما كان z image يفعله ولكن أفضل» — u/Sirmckhalifa5566)، وQwen-Image 2.1 للتحرير، وMinimax H3 لقيادة الفيديو، مع تنبيه u/Cultural-Broccoli-41 إلى أن SenseNova-U1.5 بديل قوي بترخيص Apache-2.0 ومربوط بالفعل بـComfyUI. — https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- السلسلة 10 (r/ChaiUnofficial، 5 نقاط، 2026-09-21) — مستخدمو اشتراك «ultra» المدفوع غير راضين عن مولد صور/فيديو مضاف على عجل: يقول u/ConsistentWolf2076: «كان ينبغي أن يكون توليد الصور والفيديو مجانيًا. الصور والفيديوهات ليست جيدة أصلًا. أستطيع الرسم أفضل من توليد الصور lol.» — https://www.reddit.com/r/ChaiUnofficial/comments/1wlxxa3/
الإشارات
- صاعد: يتتبع الممارسون بسرعة وبشكل عفوي تبدل الأسماء والإصدارات؛ فقد أزاح Krea 2 نموذج Z-Image Turbo، ويُذكر Minimax H3 مرارًا بوصفه الأفضل حاليًا للفيديو (السلاسل 1 و9 و11) مع انعدام الخلاف تقريبًا بين الجمهور التقني. ويُعد ترخيص Apache-2.0 لـSenseNova-U1.5 ودعمه الأصلي في ComfyUI (السلسلة 11) النقطة المفتوحة الوحيدة التي تحظى بحماسة حقيقية.
- صاعد: يجري ترشيح منصات التجميع ومتعددة النماذج مثل Luma Agents وOneOver وMagnific AI/Fal/Krea فوق اشتراكات نموذج واحد، لأن الناس ينتقلون بين النماذج أثناء المشروع نفسه (السلسلتان 1 و5).
- مرفوض / رد فعل سلبي: خارج المنتديات المركزة على الأدوات، يُقرأ كل ظهور للصور المولدة بالذكاء الاصطناعي في سياق واقعي بوصفه فضيحة لا ابتكارًا: فوز في مسابقة علمية (labrats، سلسلتان، 1,104 + 419 نقطة)، ومدير تنفيذي مفصول (594 نقطة)، واحتيال صور عقارات (27,008 نقطة)، واستطلاع قانون علامات مائية منفلت (13,925 تعليقًا). تتعامل المنتديات التقنية مع الأدوات بحياد؛ أما المنتديات العامة فتراها مشكلة ثقة.
- مفاجئ: ولّدت سلسلتا Nikon Small World طاقة أخلاقية وتفاعلًا أكبر بكثير، 1,104 و419 نقطة و134 و90 تعليقًا، من أي سلسلة فعلية تسأل «أي نموذج هو الأفضل»؛ إذ لم يتجاوز أعلى موضوع أدوات في generativeAI/StableDiffusion 13 نقطة. في Reddit حاليًا، تجذب عبارة «فيديو الذكاء الاصطناعي فعل شيئًا غير نزيه» اهتمامًا أكبر من «فيديو الذكاء الاصطناعي يفعل شيئًا جديدًا».
- خلاف: في السلسلة 4، يعدّ بعض المعلقين أي استخدام للذكاء الاصطناعي في التصوير العلمي احتيالًا صريحًا («أي شخص يعدّل اللطخة الفعلية هو محتال» — صاحب المنشور)، فيما يجادل آخرون، مثل u/thezfisher (44 نقطة)، بأن مجال معالجة الصور كله كان خاضعًا للتلاعب دائمًا وأن هذه مجرد مشكلة ظهور: «لا صورة جديرة بالثقة حقًا هذه الأيام ما لم يعرضوا تعديلات LUT الخاصة بهم.»
القيود
- لم يُجرَ على Reddit سوى بحث بعبارة واحدة، «Image and Video Generation AI News»؛ أعاد 12 سلسلة فقط، دون نحو 20 التي تتطلبها معايير الإتمام، ولم تُجرَ عمليات بحث مستقلة لزاويتي «open source» و«closed source» تحديدًا. لذلك يرجح أن هذه المجموعة تقلل من نقاشات إصدارات النماذج المخصصة، مثل غياب سلاسل إضافية من r/StableDiffusion أو أي شيء من r/MachineLearning وr/midjourney وr/OpenAI وr/aivideo.
- لم تحظَ السلسلة التقنية الأكثر ارتباطًا بالموضوع، r/StableDiffusion السلسلة 11، إلا بتصويت إيجابي واحد و20 تعليقًا؛ محتواها جيد، لكن هذا يوحي بأن عبارة البحث أظهرت الانتشار المدفوع بالجدل أكثر مما أظهرت أماكن نقاش المجتمع التقني نفسه.
- لا تسمي أي سلسلة في هذه المجموعة مباشرة إصدار نموذج مغلق أو تغيير تسعير أو إعلان شركة، مثل Midjourney أوSora أوVeo أوRunway. إشارة المصادر المغلقة هنا غير مباشرة، وتأتي من ذكر الأدوات داخل سلاسل التوصيات بدلًا من أخبار مخصصة.
- لا يمكن التحقق مستقلًا من أي من هذه الأرقام أو إعادة تصفح Reddit؛ فهذا الملف مبني بالكامل على
output/reddit.threads.md، لأن Reddit يرفض WebFetch ويحجب صفحات نتائج البحث مباشرة.
X
X — أخبار الذكاء الاصطناعي لتوليد الصور والفيديو
الحسابات
لم يُعثر، ضمن 40 منشورًا و39 حسابًا جُمعت هذه المرة، على أي حساب ينشر محتوى يتمحور حول الذكاء الاصطناعي لتوليد الصور أو الفيديو، سواء كان مغلق المصدر أو مفتوح المصدر. وإذا صُنفت المجالات قسرًا:
- العملات المشفرة، مثل رموز $ADA/$SONG: @Nadalina04 (منشوران، 25 إعجابًا)، @SintoAndrej، @EAjdarovic — منشورات ترويجية لمجتمع Cardano.
- رسائل مزعجة متكررة لمسابقات وسحوبات: @CSharp66427821، @dwayne_lepley، @DustinThel46652، @Jordan95133426 — حسابات عدة تنشر نص «Quad Goals by @Fanatics» نفسه بصورة آلية مع اختلاف الوسم فقط، ومع إعجابات تقارب الصفر.
- ثقافة الألعاب واللاعبين: @hotdropfps (سحب على حاسوب، 287 إعجابًا)، @Maki_D_Luffy، @Indie_RetroNEWS.
- جمهور F1، وتحديدًا لاندو نوريس: @ckno_ff، @4unclelala، @landoxeneize، @alukelipse — منشورات بمئات إلى ألف إعجاب عن صراعات المعجبين والدفاع عن نوريس.
- السياسة والتاريخ في يوغوسلافيا السابقة والبلقان، بما فيها النزاع الإثني: @TwiceDeadd (2,282 إعجابًا، من أكبر التفاعلات)، @mctogs، @vbspurs، @axeljarcor، @OssoKuka، @walsh_kirk91371، @jeffreybacic، @vragan95 — منشورات جدلية حول التوتر التاريخي بين صربيا وكرواتيا. القاعدة هي منشور واحد لكل حساب، والانتشار الكبير ناتج أساسًا عن منشور واحد واسع الانتشار من @TwiceDeadd.
- صور المناظر الطبيعية الإيطالية: @prjipata (مجموعة أزياء Tod's)، @PrettyCitiesX، @worldparadiseX (3,930 إعجابًا)، @naturalbeautyi7 (2,666 إعجابًا) — منشورات صور لمواقع سياحية جميلة.
- محتوى متعلق بتايلور سويفت: @_daddydisco (67,235 إعجابًا، ونحو 1.2 مليون مشاهدة، أكبر انتشار في الجولة)، @psychocrzzzy، @wandasattorney، @TSUpdating — سجلات مبيعات الإصدار الجديد ومواضيع VMAs.
المنشورات
لم يشر أي من 40 منشورًا إلى الذكاء الاصطناعي لتوليد الصور أو الفيديو. وللتوضيح، هذه أبرز المنشورات من حيث التفاعل، لكنها جميعًا خارج الموضوع.
- @_daddydisco (67,235 إعجابًا، 4,941 إعادة نشر، 191 ردًا، نحو 1.2 مليون مشاهدة، 2026-09-26) https://x.com/_daddydisco/status/2103642992342860157 — قصيدة مجازية عن «تحول الوجه إلى طين». وهي أكبر انتشار في كامل هذا الجمع، لكنها لا علاقة لها بالذكاء الاصطناعي.
- @wandasattorney (6,842 إعجابًا، نحو 138 ألف مشاهدة، 2026-09-28) https://x.com/wandasattorney/status/2104362546107191455 — موضوع عن VMAs: «LISA winning best pop over Taylor Swift…».
- @TwiceDeadd (2,282 إعجابًا، 295 إعادة نشر، 55 ردًا، نحو 35 ألف مشاهدة، 2026-09-27) https://x.com/TwiceDeadd/status/2104209913228771333 — نكتة سياسية بلقانية بعنوان «we gotta try yugoslavia again» انتشرت على نطاق واسع.
- @worldparadiseX (3,930 إعجابًا، نحو 91 ألف مشاهدة، 2026-09-26) https://x.com/worldparadiseX/status/2103775750486986847 — صورة لمناظر Passo Giau في إيطاليا.
- @psychocrzzzy (2,995 إعجابًا، نحو 60 ألف مشاهدة، 2026-09-27) https://x.com/psychocrzzzy/status/2104213800610152704 — موضوع عن سجل أغنية تايلور سويفت الجديدة على Spotify.
لا يرتبط أي منها باتجاهات الذكاء الاصطناعي لتوليد الصور والفيديو، سواء المغلقة أو المفتوحة، مثل إطلاق نماذج جديدة أو تحديث أدوات أو نقاشات المقارنة.
الإشارات
- عبارات البحث هذه المرة لم تطابق الموضوع: العبارات المستخدمة، مثل "$SONG" و"#chance" و"#sweepstakes" و"#giveaways" و"#gaming" و"Lando" و"Yugoslavia" و"Croats" و"Italy" و"Taylor"، ليست مرتبطة بالذكاء الاصطناعي لتوليد الصور أو الفيديو؛ ويبدو أنها كلمات رائجة من X Explore، مع إعداد محلي لكرواتيا بسبب الجلسة، جرى استخدامها كما هي. لذلك انحصر المحتوى في خمس فئات: العملات المشفرة، ورسائل السحب المزعجة، وجمهور F1، والجدالات التاريخية البلقانية، وصور السياحة، وتايلور سويفت، دون أي أثر لأخبار الذكاء الاصطناعي.
- لم تتضمن أي من المنشورات الأربعين كلمات مثل «AI» أو«توليد صور» أو«توليد فيديو» أو«Midjourney» أو«Stable Diffusion» أو«Sora».
- لا توجد حتى حالة واحدة تسمح بربط معقول بالذكاء الاصطناعي، ويجب تجنب اختلاق هذا الربط.
القيود
- حُدد موقع X Explore، أي قائمة الاتجاهات، جغرافيًا وفق مصدر اتصال هذه الجلسة على أنه كرواتيا. كانت الاتجاهات من 1 إلى 4 و8 و10 «رائجة في كرواتيا»، و5 في «Gaming»، و6 في «Motorsport»، و7 في «Politics»، و9 في «Sports». جميعها اتجاهات محلية لمنطقة واحدة وليست اتجاهات عالمية، فضلًا عن أن تكون اتجاهات لصناعة الذكاء الاصطناعي.
- الكلمات العشر التي بُحث عنها بالفعل، $SONG و#chance و#sweepstakes و#giveaways و#gaming وLando وYugoslavia وCroats وItaly وTaylor، يُرجح أن العامل استخدمها مباشرة من اتجاهات Explore، لكنها لا تتصل بموضوع الذكاء الاصطناعي لتوليد الصور أو الفيديو. لذلك لم يُجرَ جمع جديد باستخدام عبارات ملائمة مثل «image generation AI» أو«video generation AI» أو«Stable Diffusion» أو«Midjourney» أو«Sora».
- تحقق معيار تحليل نحو 20 منشورًا من حيث العدد، إذ جُمعت 40 منشورًا، لكن عدم وجود أي منشور ملائم يعني أن متطلب عشر ملاحظات على الأقل لكل من المصادر المغلقة والمفتوحة لا يمكن الوفاء به باستخدام بيانات X.
- لا توجد وسيلة وصول إضافية إلى X نفسه، غير الملفات المجمعة
output/x.posts.mdوoutput/x.posts.json، لأن هذه المرحلة تقرأ بيانات جُمعت مسبقًا فقط. ولذلك تعذر إعادة الجمع بكلمات بحث مناسبة ضمن صلاحيات هذه المرحلة.
YouTube
YouTube — أخبار الذكاء الاصطناعي لتوليد الصور والفيديو (مصادر مغلقة مقابل مفتوحة)
القنوات
كان إسناد القنوات صعبًا في هذه الجولة، كما هو موضح في القيود؛ إذ لم تعرض صفحات /watch و/results في YouTube عبر WebFetch سوى محتوى ثابتًا في التذييل، لذا جاءت معظم أسماء القنوات أدناه من مقتطفات WebSearch لا من الصفحة نفسها.
- Woollyfern — يقدم سلسلة شهرية متكررة باسم «Midjourney Update» تغطي كل تحديث إصدار، من V8 إلى V8.1 ثم V8.2 خلال 2026.
- تغطي قنوات كثيرة للدروس والمقارنات حزمة ComfyUI المفتوحة، مثل Qwen-Image وLTX وWan، إصدارًا بإصدار، لكن لم يمكن تأكيد أسماء القنوات الفردية من مقتطفات البحث وحدها. تظل العناوين والروابط حقيقية وقابلة للتتبع، كما في قائمة الفيديوهات أدناه.
- تنشر قنوات عامة لملخصات أخبار الذكاء الاصطناعي، مثل صاحب «Exciting AI Updates Weekly»، ملخصات أسبوعية تمس إصدارات توليد الصور والفيديو المغلقة والمفتوحة معًا.
الفيديوهات
-
مراجعة GPT Image 2.5: ما الذي تغير وكيف تستخدمه فعليًا
— قناة "Aristotto" — نُشر بعد 8 سبتمبر 2026 بوقت قصير —
https://www.youtube.com/watch?v=QOfLgJ3TCrQ
يرى أن وضعي GPT Image 2.5، Flare للسرعة وSunburst للتفاصيل، يحسنان التزام الصور المرجعية وموثوقية التعديل متعدد الجولات بدرجة ملموسة مقارنة بـGPT Image 2.0، مع انخفاض زمن الاستجابة بنحو 50%. -
GPT Image 2.5 وصل — كل ما تحتاج إلى معرفته
— القناة غير محددة — نُشر نحو 22 سبتمبر 2026، وفق مقتطف البحث «منذ 6 أيام» —
https://www.youtube.com/watch?v=20vo5nW9yXI
يستعرض التغييرات من GPT Image 2.0 إلى 2.5، بما فيها إخراج PNG/WebP أصلي بخلفية شفافة. -
Qwen-Image-2.1 مذهل... 7B معاملات فقط؟!
— القناة غير محددة — نُشر نحو 22–24 سبتمبر 2026، وأُطلق Qwen-Image-2.1 في 21 سبتمبر 2026 وفق MarkTechPost —
https://www.youtube.com/watch?v=3qGl0wiv2G0
يرى أن Qwen-Image-2.1 من Alibaba، المفتوح الأوزان بحجم 7B، يتفوق كثيرًا على ما يوحي به عدد معاملاته ويقترب من النماذج المغلقة الأكبر بكثير. -
نموذج 7B يتفوق على Nano Banana 2.0؟ أتقن Qwen Image 2.1: دقة 2K أصلية وRGBA وسير عمل 10 صور
— القناة غير محددة — نُشر نحو 23 سبتمبر 2026 —
https://www.youtube.com/watch?v=fwHS0ubmI7I
يدعي أن Qwen-Image-2.1 يتفوق على Nano Banana 2.0 من Google في عدة مهام أثناء تشغيله محليًا، ويعرض إخراج 2K أصليًا وشفافية RGBA وتحريرًا باستخدام 10 صور مرجعية. -
LTX-2.5 وصل: أسرع نموذج فيديو مفتوح بالذكاء الاصطناعي حتى الآن؟
— القناة غير محددة — 16 أغسطس 2026 —
https://www.youtube.com/watch?v=qVGpyw-F-rw
مراجعة أولى لـLTX-2.5 مفتوح الأوزان من Lightricks، تضعه في مواجهة MiniMax H3 وSeedance 2.5 من حيث سرعة التوليد. -
تشغيل أوزان LTX-2.5 المفتوحة في ComfyUI — هل هذا أفضل؟
— القناة غير محددة — 12 أغسطس 2026 —
https://www.youtube.com/watch?v=XAhuGRCI2tM
إعداد واختبار محلي لـLTX-2.5 في ComfyUI يوم إطلاق أوزانه المفتوحة، مع سؤال عما إذا كان يتفوق على قاعدة LTX-2 السابقة. -
اختبرت WAN 3.0 في خمسة تحديات فيديو بالذكاء الاصطناعي مذهلة
— القناة غير محددة — 20 أغسطس 2026 —
https://www.youtube.com/watch?v=5Hb429VYNUU
يختبر Wan 3.0 من Alibaba، في بيتا عامة وبمقاطع 30 ثانية، باختبارات ضغط ويقارنه بـSeedance؛ وينوه إلى أن Wan 3.0 حاليًا عبر API/بيتا فقط وليس مفتوح الأوزان مثل إصدارات Wan السابقة. -
أنشأ Alibaba Wan 3.0 إعلان تطبيق لمدة 30 ثانية مقابل 1.27 دولار
— القناة غير محددة — 24 أغسطس 2026 —
https://www.youtube.com/watch?v=fHK7oYrokZY
عرض للتكلفة والجودة في Wan 3.0 بعد وقت قصير من وصوله إلى OpenRouter، ويعرضه كبديل رخيص لمولدات الفيديو المغلقة. -
تحديث Midjourney | يوليو 2026: V8.2 هنا! التخصيص، ومنشئ نمط NIJI، والمزيد!
— قناة Woollyfern — نُشر في يوليو 2026 —
https://www.youtube.com/watch?v=dvfH5HzCARY
يستعرض ميزات التخصيص ومنشئ نمط NIJI في V8.2؛ وهو جزء من وتيرة شهرية تتابع خارطة طريق Midjourney المغلقة، من V8 إلى V8.1 ثم V8.2 بين فبراير ويوليو 2026. -
Kling 3.0 مقابل Grok Imagine مقابل Runway Gen-4.5 مقابل Veo 3.1: مقارنة الفيديو بالذكاء الاصطناعي النهائية
— القناة غير محددة — نحو 10 مارس 2026، أقدم من نافذة الـ60 يومًا لكنه أُبقي لأنه أوضح فيديو واحد يقارن أربعة مولدات فيديو مغلقة وجهًا لوجه —
https://www.youtube.com/watch?v=x5fMQvhKP60
يرتب مولدات الفيديو المغلقة الأربعة وفق الجودة السينمائية وتزامن الشفاه واتساق اللقطات المتعددة. -
تحديثات مثيرة للذكاء الاصطناعي أسبوعيًا — 25 سبتمبر 2026
— المنشئ "Lev Selector" — 25 سبتمبر 2026 —
https://www.youtube.com/watch?v=iyZHPCNd8jI
ملخص أسبوعي للذكاء الاصطناعي العام يضم إصدارات الصور والفيديو، مثل GPT Image 2.5 وQwen-Image-2.1، إلى جانب أخبار أوسع.
الإشارات
- تغلق النماذج المفتوحة الأوزان الفجوة بسرعة، وتقول ذلك بصراحة. تصوغ عدة عناوين فيديو في هذه الجولة Qwen-Image-2.1 المفتوح بحجم 7B من Alibaba على أنه يتفوق على Nano Banana 2.0 الأضخم بكثير من Google أو يساويه (#3، #4). لم يعد إطار «نموذج مفتوح صغير يتفوق على نموذج مغلق كبير» خطافًا عابرًا بل أصبح متكررًا.
- يتسابق الفيديو المفتوح في سرعة التشغيل المحلي، لا الجودة وحدها. تُغطى LTX-2.5 (#5، #6) وسلسلة Wan (#7، #8) بصورة رئيسية من خلال فيديوهات إعداد ComfyUI واختبار السرعة، لا مقاطع ترويجية لامعة؛ فالجمهور يهتم بتشغيلها على بطاقته الرسومية الخاصة.
- يتجه فيديو المصادر المغلقة نحو التجمّع. تغلق OpenAI واجهة Sora 2 API بالكامل في 24 سبتمبر 2026، وفق تأكيد مركز المساعدة الخاص بـOpenAI وعدة وسائل، رغم أن هذه الجولة لم تعثر على فيديو YouTube مخصص للرد على الخبر؛ وفي الوقت نفسه ورد أن Wan 3.0 من Alibaba تجاوز Sora في التصنيفات العالمية لنماذج الفيديو. تنكمش المنافسة المغلقة إلى Veo وKling وGrok وRunway وSeedance.
- يشحن رواد الصور المغلقة تحديثات شهرية أو نقطية. يوضح V8 → V8.1 → V8.2 من Midjourney (#9) وGPT Image 2.0 → 2.5 من OpenAI (#1، #2) وجود تحديثات نقطية متكررة بدلًا من إصدارات ضخمة متباعدة؛ وقد تكيّفت قنوات التغطية مع ذلك بصيغة فيديوهات التحديث الشهرية المتكررة.
- Wan 3.0 إشارة جزئية، لا انتصارًا نظيفًا للمصادر المفتوحة: فهو حاليًا عبر API/بيتا عامة فقط (#7، #8)، خلافًا لسلسلة Wan 2.x المفتوحة الأوزان، لذا يبدو أن Alibaba توازن بين التوزيع المفتوح والمغلق.
القيود
- تعذر جلب أعداد المشاهدات والمشتركين. أعادت WebFetch عند زيارة
youtube.com/watch?v=...وyoutube.com/results?search_query=...محتوى تذييل YouTube القانوني الثابت فقط؛ إذ توجد أرقام المشاهدات والمشتركين فيytInitialDataالذي يرسمه JavaScript ولم يصل في المحتوى المجلب. ولم تحتوِ مقتطفات WebSearch على هذه البيانات أيضًا، لذا تُركت جميع أرقام «المشاهدات» و«المشتركين» خارج التقرير بدلًا من تخمينها. - تعذر تأكيد أسماء قنوات عديدة. حيث لم تسمِّ مقتطفات WebSearch المنشئ، أُشير إلى العناصر أعلاه بعبارة «القناة غير محددة» بدلًا من التخمين.
- لم يظهر فيديو YouTube مخصص يتفاعل مع إغلاق Sora 2 API، رغم تأكيده في 24 سبتمبر 2026 من مصادر غير YouTube، وذلك رغم عدة عمليات بحث مستهدفة؛ ذُكر كخلفية في الإشارات لا كاكتشاف من YouTube.
- مال نطاق البحث إلى مقتطفات Google المفهرسة من YouTube بدلًا من واجهة البحث الحية التي لم يمكن جلبها. ومن المرجح أن هذا يقلل من تمثيل الرفعات الحديثة جدًا خلال الأيام القليلة الأخيرة التي لم يفهرسها Google بالكامل بعد.
Bluesky
Bluesky — أحدث اتجاهات الذكاء الاصطناعي لتوليد الصور والفيديو
الحسابات
- gen-ai.news(@gen-ai.news)— حساب ينشر أخبار صناعة الذكاء الاصطناعي التوليدي تلقائيًا. بين 18 و27 سبتمبر 2026، نشر ملخصات لمقالات متعلقة بتوليد الصور والفيديو بمعدل منشور إلى ثلاثة يوميًا، وجاءت منه معظم «الأخبار الحديثة» التي عُثر عليها في هذه المرحلة.
- sungkim.bsky.social(@sungkim.bsky.social)— محلل أعمال يتابع الذكاء الاصطناعي وتعلم الآلة وتحليل البيانات. لديه 8,690 متابعًا، وينشر كثيرًا تحديثات سريعة عن إصدارات النماذج المفتوحة الأوزان.
- edzitron.com(@edzitron.com)— حساب صادر عن نشرة إخبارية معروفة بنقد صناعة التقنية. انتشر منشوره عن Sora على نطاق واسع كما سيرد لاحقًا.
- richargh.de(@richargh.de)— نشر رأيًا عن إغلاق Sora من زاوية اقتصاديات الوحدة.
- luok.ai(@luok.ai)、adinayakup.bsky.social(@adinayakup.bsky.social)— ناشران يقدمان معلومات تقنية عن نماذج الفيديو المفتوحة، مثل سلسلة SkyReels.
- dahara1.bsky.social(@dahara1.bsky.social)— مستخدم ينشر تجارب بيتا للذكاء الاصطناعي التوليدي باللغة اليابانية.
المنشورات
تحركات المصادر المغلقة
- OpenAI تنهي Sora — @edzitron.com، 2026-03-24، 👍3,571 🔁984 💬99. ينقل تقارير WSJ وThe Information ويعلّق: «إنها ستنهي الوصول ليس إلى التطبيق فقط بل إلى واجهة API للمطورين أيضًا، وهي خطوة ملحّة جدًا». أكبر انتشار للموضوع على Bluesky.
- رأي بأن إغلاق Sora فشل في اقتصاديات الوحدة — @richargh.de، 2026-03-25، 👍2 🔁0. تحليل يقول: «ربما أدركوا أن اقتصاديات الوحدة لتوليد الفيديو سيئة جدًا. وربما لم يستطيعوا تحويل المستخدمين المجانيين إلى مدفوعين».
- تنفيذ إغلاق Sora API اعتبارًا من 2026-09-24 (تأكد عبر مجموعة مقالات gen-ai.news ونتائج البحث، من دون العثور على منشور Sora نفسه. المصدر: Wikipedia: Sora للتحقق من التاريخ).
- GWM 2 من Runway — gen-ai.news، 2026-09-27. نموذج عالم «لا يولد مقاطع فحسب، بل يستمر في فهم البيئة».
- Runway تطور بث فيديو فوريًا عبر GWM-1 — gen-ai.news، 2026-09-20. يعرض تطبيقات محتملة في الروبوتات والقيادة الذاتية أيضًا.
- نسخة ألفا من Midjourney تدعم معاينة مباشرة للأسلوب — gen-ai.news، 2026-09-27، مع تغييرات سابقة في مقال 09-25. أصبح بالإمكان رؤية مظهر الأسلوب قبل التوليد.
- مجموعة أدوات Adobe الإبداعية تتكامل مع Gemini/Claude — gen-ai.news، 2026-09-26. يمكن استخدام Photoshop وLightroom وFirefly وAcrobat مباشرة من واجهة المحادثة.
- Adobe تكمل الاستحواذ على Topaz Labs — gen-ai.news، 2026-09-25. دمج مبكر لتقنيات رفع الدقة بالذكاء الاصطناعي في Firefly وPhotoshop، مع استمرار علامة Topaz في الوقت الراهن.
- OpenAI تستحوذ على Glass Imaging مقابل 300 مليون دولار — gen-ai.news، 2026-09-19. شركة ناشئة لمعالجة الصور في كاميرات الهواتف، ويحلل الخبر كتحرك يستهدف كامل مسار الصور من التوليد إلى الالتقاط.
- Dramagic من ByteDance تولد 95% من الدراما القصيرة الصينية بالذكاء الاصطناعي — gen-ai.news، 2026-09-22. منصة تمتد من النص إلى الفيديو من دون طاقم بشري.
- مجلس رقابة Meta يأمر بحذف فيديوهات deepfake — gen-ai.news، 2026-09-19. ويطلب من Meta تعزيز سياسات الكشف والحذف أيضًا.
تحركات المصادر المفتوحة
- Alibaba تطلق Qwen-Image-2.1 مفتوح الأوزان — @sungkim.bsky.social، 2026-09-20، 👍82 🔁10 💬4. يصفه بأنه «بنية خفيفة بحجم 7B تدمج التوليد والتحرير، وتسرّع كثيرًا استدلال المدخلات متعددة الصور».
- شرح مفصل للنموذج نفسه — gen-ai.news، 2026-09-20. «نموذج توليد صور مفتوح الأوزان بحجم 7B يعمل على بطاقات GPU للمستهلكين، ويدعم الطبقات الشفافة وما يصل إلى 10 صور مرجعية في وقت واحد، ويدعي أداءً مكافئًا للنماذج المغلقة الكبيرة في الاختبارات المعيارية».
- SkyReels V1، أول نموذج أساس فيديو مفتوح المصدر مخصص للشخصيات — @luok.ai، 2025-02-18، 👍3 🔁1. يشرح أنه ضُبط انطلاقًا من HunyuanVideo باستخدام أكثر من 10 ملايين مقطع فيديو، ويلتقط 33 تعبيرًا و400 حركة أو أكثر.
- SkyReels-A2، إطار لتوليد فيديو قابل للتحكم من النص والصورة — @adinayakup.bsky.social، 2025-04-04، 👍3 🔁2. قُدم بوصفه إطارًا مفتوحًا من Skywork وKunLun.
- تجربة اختبار بيتا لـHunyuanVideo باللغة اليابانية — @dahara1.bsky.social، 2025-03-06. ينشر المستخدم أن النظام أصبح قادرًا على توليد فيديو بصوت من صورة واحدة، I2V، مع نتائج مزامنة شفاه بأسلوب رسوم متحركة.
الإشارات
- كثافة أخبار المعسكر المغلق مرتفعة في أواخر سبتمبر: أصدرت Runway وAdobe وMidjourney وOpenAI وMeta وByteDance وPinterest إعلانًا أو استحواذًا أو تغيير سياسة تقريبًا كل يوم خلال الأيام العشرة بين 18 و27 سبتمبر 2026، وتابعت حسابات أخبار الذكاء الاصطناعي على Bluesky ذلك.
- جوّ «توليد الفيديو غير مربح»: يُعامل إغلاق Sora، بـ3,571 إعجابًا، بوصفه نقطة تحول واضحة، وتصبح تقييمات مثل تحليل richargh.de بأن «اقتصاديات الوحدة سيئة» فهمًا شائعًا في المجتمع.
- Alibaba Qwen حاضرة بقوة في الصور المفتوحة: تناول كل من حساب شخصي، sungkim.bsky.social، وحساب إخباري، gen-ai.news، Qwen-Image-2.1 في اليوم نفسه. وكانت 82 إعجابًا أكبر تفاعل لمنشور شخصي رُصد في هذه المرحلة. محور الحديث هو ادعاء «نموذج خفيف 7B ينافس نماذج مغلقة كبيرة».
- منشورات الفيديو المفتوح الفردية قليلة وقديمة أيضًا: تعود منشورات SkyReels وHunyuanVideo إلى النصف الأول من 2025؛ ولم يعثر بحث Bluesky على منشورات شخصية ذات معنى حول Wan 2.7 أوLTX-2.3 أوFLUX.2 في سبتمبر 2026.
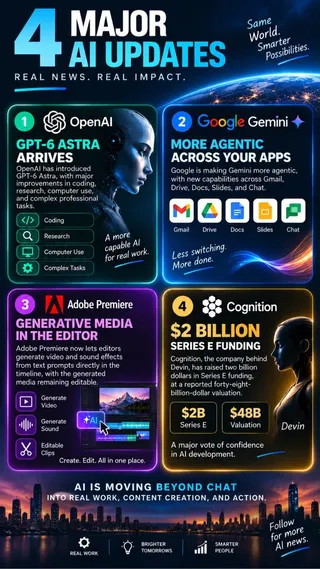
- هناك آلية تصحيح ذاتي لدقة أخبار الصناعة: أعلن gen-ai.news في منشور بتاريخ 2026-09-23 أن «GPT-6 و“Astra” غير موجودين. لا يمكنني كتابة منشور عن هذا المقال لأنه يتضمن أسماء منتجات مختلقة»، ما يدل على موقف بعدم النشر دون تحقق. لكن منشورًا من الحساب نفسه بتاريخ 2026-09-21 ذكر أن «Higgsfield AI أضاف ميزات بسرعة عبر GPT-4o وإطار OpenAI المسمى “Astra”»، وهذا يناقض إقراره السابق بأن Astra غير موجود. من المرجح أن أحدهما خاطئ، لذا ينبغي عدم اعتماد الادعاءات المتعلقة بـAstra كما هي.
القيود
- أعادت واجهة البحث الرسمية في Bluesky،
app.bsky.feed.searchPosts، خطأ 403 Forbidden باستمرار في هذه الجلسة، لذلك تعذر إجراء بحث شامل بالكلمات المفتاحية. بدلًا من ذلك، اكتُشفت المنشورات والحسابات عبر Web search باستخدامsite:bsky.app، ثم جرى التحقق من النصوص والتواريخ وأعداد الإعجابات مباشرة عبرapp.bsky.feed.getPostThreadوapp.bsky.feed.getAuthorFeed، وهما واجهتان عامتان لا تتطلبان مصادقة. - لم تُظهر صفحات المنشورات في
bsky.app، المرسومة عبر JavaScript، النصوص أو الأرقام في WebFetch، ولم يكن يمكن قراءة سوى اسم المؤلف. لذلك تقتصر كل الأرقام على ما جُلب عبر الواجهات المذكورة أعلاه. - لم يُعثر على منشورات شخصية ذات معنى في Bluesky حول نماذج الصور والفيديو المفتوحة التي يُفترض أنها رائجة في سبتمبر 2026، مثل FLUX.2 وWan 2.7 وLTX-2.3 ومشاركات سير عمل ComfyUI. فُحصت مباشرة موجزات حسابات مثل fluxkontext.bsky.social وwagahai-ai.bsky.social وaoi68k.bsky.social، لكنها جميعًا توقفت تقريبًا عند النصف الأول من 2025 ولم تعكس المواضيع الحديثة.
- مقابل معيار إتمام تحليل نحو 20 منشورًا، لم يُتحقق من النصوص والأرقام إلا لـ16 منشورًا بالفعل، 11 للمصادر المغلقة و5 للمصادر المفتوحة. وهي منحازة إلى حساب gen-ai.news، وتبقى ضعيفة من حيث النقاش الطبيعي الذي يصدر عن عدة مستخدمين أفراد.
- عُثر على عدة حسابات من مجتمع اليابانية، مثل وسوم رسوم الذكاء الاصطناعي وفيديو الذكاء الاصطناعي، لكن محتواها كان قديمًا من 2024–2025 أو مجرد منشورات أعمال عامة بلا قيمة إخبارية، لذا لم يُعتمد بوصفه معرفة حديثة لهذه الجولة.
Lemmy
Lemmy — أحدث اتجاهات الذكاء الاصطناعي لتوليد الصور والفيديو
المجتمعات
- !«メールアドレス» — 5,714 عضوًا. هو المركز الفعلي الوحيد على Lemmy لموضوعات الذكاء الاصطناعي المفتوح الأوزان لتوليد الصور والفيديو. تُنشر فيه روابط GitHub/HuggingFace يوميًا تقريبًا، لذلك يشبه «موجز أخبار عاجلة».
- !«メールアドレス»، مع مرآة على sh.itjust.works — نحو 5,180 عضوًا. مجتمع عام للنماذج اللغوية المحلية، وتظهر فيه أحيانًا موضوعات توليد الصور، لكن لم يُعثر على منشورات حديثة عن توليد الصور أو الفيديو خلال فترة الجمع هذه.
- !«メールアドレス» — 1,662 عضوًا. موجود لكنه لم يظهر نشاط حديث يذكر، وهو مجتمع هادئ.
- !fuck_ai عبر مثيلات عدة، منها lemmy.world وlemmy.dbzer0.com وlemmy.zip وdiscuss.online وlemmy.blahaj.zone — رغم حجمه، يحقق تفاعلًا ملحوظًا من عشرات إلى أكثر من 800 إعجاب للمنشور، ويتناول معارضة الذكاء الاصطناعي عمومًا، لكن المنشورات المتخصصة في الذكاء الاصطناعي لتوليد الصور والفيديو قليلة جدًا.
- !«メールアドレス»، ونسخه على مثيلات مختلفة — مجتمع تقني عام تصل إليه أخبار المصادر المغلقة لتوليد الصور والفيديو كمنشورات منفردة. ولم يُعثر على مجتمع مخصص.
- !«メールアドレス» / !«メールアドレス»، !«メールアドレス»، !«メールアドレス» — أمثلة لمجتمعات ألعاب أو علامات تجارية معينة تصلها أخبار حول المحتوى المولد بالذكاء الاصطناعي بصورة منفردة.
المنشورات
جانب المصادر المفتوحة، من !«メールアドレス»
- Qwen-Image-2.1 في ComfyUI: توليد وتحرير صور مفتوح الأوزان، الآن مع الشفافية — نتيجة 14، 2026-09-22. دُمج نموذج Alibaba المفتوح الأوزان Qwen-Image-2.1 في ComfyUI، ويدعم الإخراج الشفاف، قناة ألفا. https://lemmy.dbzer0.com/post/75874773
- SupraLabs/Supra2-IMG — نتيجة 8، 2026-09-22. نموذج text-to-image خفيف للغاية بـ100 مليون معامل، دُرب باستخدام بيانات اصطناعية فقط. وُصف بأن لديه «جودة متقدمة مقارنة بحجمه». https://lemmy.dbzer0.com/post/75874769
- AI Horde: واجهة جديدة، وواجهة أمامية جديدة، وخلفية جديدة، ووثائق تجديد شامل — نتيجة 9، 2026-09-19. تحديث لخدمة توليد صور موزعة ومجانية يطورها أيضًا مدير مثيل Lemmy هذا، db0. https://lemmy.dbzer0.com/post/75736717
- well9472/Nanosaur2-670M، بدعم ComfyUI — نتيجة 4، 2026-09-27. نموذج DiT لتحويل النص إلى صورة متخصص في الرسوم التوضيحية وبحجم 670 مليون معامل، كلف تدريبه 600 دولار فقط. https://lemmy.dbzer0.com/post/76110122
- تركيز المنشورات على مجموعة أدوات MiniMax H3 — بين 13 و26 سبتمبر 2026، نُشرت تباعًا أكثر من خمس أدوات، منها AutoContext الذي يتجاوز قيود الذاكرة للفيديو الطويل وواجهة تحكم كاميرا ثلاثية الأبعاد وعقد تحرير الخط الزمني وLoRA لتسريع ثلاث خطوات باسم TaoMate-H3، بنتائج من 1 إلى 6. وهذا يوحي بأن MiniMax H3 هو ساحة العمل الحالية لتوليد الفيديو في هذا المجتمع. مثال: https://lemmy.dbzer0.com/post/75586069
- أدوات LoRA وتسريع حول Krea 2 — «Krea2-Turbo-Distill-2step-LoRA»، لإزالة التشويش أسرع بـ4.2 مرات، نتيجة 2 في 2026-09-16، و«krea2-inpaint-edit»، LoRA لتحرير الأقنعة، نتيجة -1 في 2026-09-26. يبدو أن Krea2 تستقر كهدف تستطيع المجموعة بناء LoRA مخصصة له.
جانب المصادر المغلقة، المتناثر في المجتمعات العامة
- Midjourney تطلب من استوديوهات أفلام هوليوود كشف ممارسات استخدام الذكاء الاصطناعي — !«メールアドレス»، 2026-07-05. https://lemmy.today/post/56011946
- Stanford تقر باستخدام صور طلاب لمعالجة بالذكاء الاصطناعي «تغير العرق» — !«メールアドレス»، نتيجة 3، 2026-09-23. https://lemmy.world/post/52274704
- ميزة Google Earth الجديدة للذكاء الاصطناعي تسمح لأي شخص بصنع صور أقمار صناعية مزيفة — !«メールアドレス»، 2026-08-04. https://sh.itjust.works/post/64574916
- DC تحذف من YouTube فيديو خلف الكواليس بعدما تبيّن أنه يستخدم رسومات مفاهيم مولدة بالذكاء الاصطناعي — !«メールアドレス»، نتيجة 5، 2026-08-13. https://lemmy.today/post/58316222
- إعلان Meta يروج لتطبيق nudify يستهدف مراهقين حقيقيين باعتباره «الذكاء الاصطناعي الذي يستخدمه الرجال فعليًا» — !«メールアドレス»، 2026-09-08. https://lemmy.dbzer0.com/post/75191260
- EA تتعاون مع الشركة التي طورت Stable Diffusion، Stability AI، لإنتاج الألعاب بالذكاء الاصطناعي — !«メールアドレス»، نتيجة 2، 2025-10-25. https://mander.xyz/post/40602787
- منشور ميم يسخر من «OpenAI تنهي نموذج فيديو الذكاء الاصطناعي الرديء Sora» — !«メールアドレス»، نتيجة 0، 2026-03-25. في سياق ساخر من خبر إغلاق Sora API الحقيقي. https://lemmus.org/post/21091066
الإشارات
- تركيز أحادي في جانب المصادر المفتوحة: جاءت تقريبًا جميع المنشورات التطويرية التي عُثر عليها من مجتمع واحد، !«メールアドレス»، ومن ناشر واحد تقريبًا، Even_Adder، مع مدير المثيل db0. عدد التعليقات يقارب الصفر في جميع المنشورات تقريبًا، لذا يشبه المكان قائمة روابط جديدة من GitHub/HuggingFace أكثر من كونه مكانًا للنقاش.
- مركز الثقل الحالي للتطوير هو Qwen-Image-2.1 للصور وMiniMax H3 للفيديو: معظم منشورات الأدوات في الأسبوعين الأخيرين كانت محولات أوLoRA أوعقد ComfyUI لهذين النموذجين. وسمّى جانب Reddit،
output/reddit.md، النموذجين نفسيهما، Qwen-Image 2.1 للتحرير وMinimax H3 للفيديو، بوصفهما «الأقوى حاليًا»، ما يوفر تأكيدًا عبر المنصات. - لا تصل موضوعات المصادر المغلقة إلا عبر الجدل والأخلاقيات، لا أخبار الميزات: منشورات Midjourney وGoogle وMeta وDC لا تتناول ميزات جديدة، بل حقوق النشر وdeepfake وانتحال الهوية والتزوير. ولا يوجد في Lemmy مجتمع يتابع تقنيًا تحديثات النماذج المغلقة مثل Sora أوVeo أوKling أوGrok Imagine.
- !fuck_ai ليس متخصصًا في توليد الصور والفيديو رغم حجمه: تحقق المنشورات الفردية عشرات إلى أكثر من 800 إعجاب، لكن مركز الحديث هو تجاوزات وكلاء النماذج اللغوية، مثل «Claude Code حذف 48,000 ملف في 103 ثوانٍ» أو«وكيل OpenAI عدّل موقعًا حكوميًا»، فيما تشكل الإشارات إلى الذكاء الاصطناعي لتوليد الصور والفيديو أقلية.
- البحث المباشر بأسماء المنتجات المغلقة الكبرى لم ينجح غالبًا: أعادت عمليات البحث عن «Kling AI» و«Veo 3» و«Adobe Firefly» و«Nano Banana» و«Grok Imagine» نتائج غير ذات صلة فقط، ولم يُتحقق تقريبًا من منشورات أو نقاشات مخصصة تحمل هذه الأسماء على Lemmy.
القيود
- دقة بحث Lemmy، سواء عبر واجهة lemmy.world أوالبحث داخل الموقع، ضعيفة وتعيد عددًا كبيرًا من المنشورات غير ذات الصلة بالكلمات المفتاحية؛ فعند البحث عن «Kling AI» مثلًا تظهر سلسلة عن خصومات السكك الحديدية الألمانية. لذلك لا يمكن الجزم بأن عدم ظهور نتيجة في البحث يعني أن الموضوع غير متداول.
- يعتمد مصدر معلومات المصادر المفتوحة فعليًا على مجتمع واحد وحساب أو حسابين؛ أما المجتمعات المشابهة على مثيلات أخرى، مثل lemmy.ml وlemm.ee، فأعداد مشتركيها قليلة ولم يظهر فيها نشاط تقريبًا.
- لا يوجد تجمع مخصص للمصادر المغلقة؛ فكان لا بد من جمع منشورات منفردة من مجتمعات عامة مثل technology وnottheonion وgames وdcstudios وgooglepixel. التغطية منخفضة الشمول.
- فُتحت أكثر من 40 منشورًا عبر قوائم المجتمعات ونتائج البحث في هذا المسح، 20 منشورًا حديثًا من مجتمع stable_diffusion إضافة إلى نتائج عديدة من عمليات بحث متنوعة، وبذلك تحقق معيار «نحو 20» من حيث العدد. لكن المنشورات التي شهدت نقاشًا نشطًا في التعليقات قليلة جدًا، ومعظمها لم يحظَ بتعليقات تقريبًا.
- Lemmy ككل صغيرة من حيث المستخدمين والمنشورات، ولذلك فهي أضعف بكثير من Reddit وX وBluesky وغيرها كمكان لمتابعة «أحدث أخبار» الذكاء الاصطناعي لتوليد الصور والفيديو.
Pinterest — أخبار الذكاء الاصطناعي لتوليد الصور والفيديو
من بين 50 دبوسًا جُمعت (pinterest.pins.md، manifest.json)، فُتحت 26 صورة فعليًا وفُحصت. تم الجمع باستعلام واحد غير مصنف: "Image and Video Generation AI News".
الموضوعات البصرية
- هيمنة إخراج «ذكاء اصطناعي» بخلفية سوداء وأزرق/أرجواني نيون: تظهر مرارًا أيدٍ ووجوه روبوتية متوهجة وأنماط دوائر مضيئة وشعارات تايبوجرافية لـ
AI. وهي النغمة البصرية الغالبة تقريبًا [1, 7, 8, 20, 37, 38, 40]. - تُستخدم الروبوتات البشرية البيضاء، بملمس أملس وعيون أو مفاصل متوهجة بالأزرق، بكثافة كأيقونة مجسدة للـ«AI» [8, 20, 37, 38, 40]. وهي أكثر شيوعًا بكثير من لقطات واجهات المنتجات الفعلية.
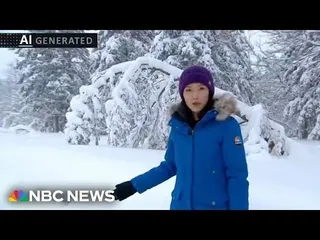
- يشكل تصميم التحذير أو المقارنة «هذا مولد بالذكاء الاصطناعي» نوعًا قائمًا بذاته: أختام كشف التزوير، وصور مقسمة للمقارنة بين الإنسان والذكاء الاصطناعي، ولقطات لمقاطع أخبار مولدة بأسلوب مذيع؛ وهي مواد تركز على «كيف تميزه» أوتغذي عدم الثقة [3, 32, 39, 42, 43, 44, 45, 48].
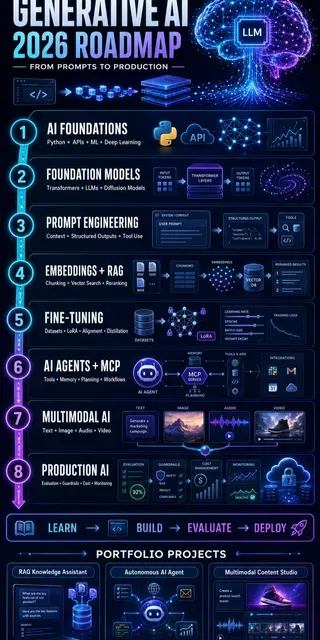
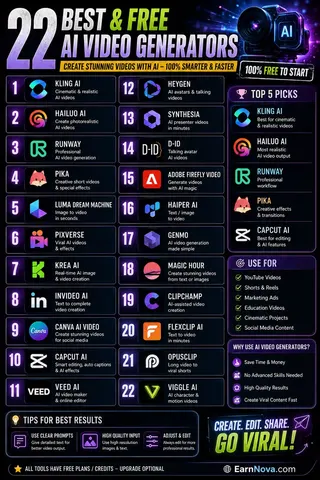
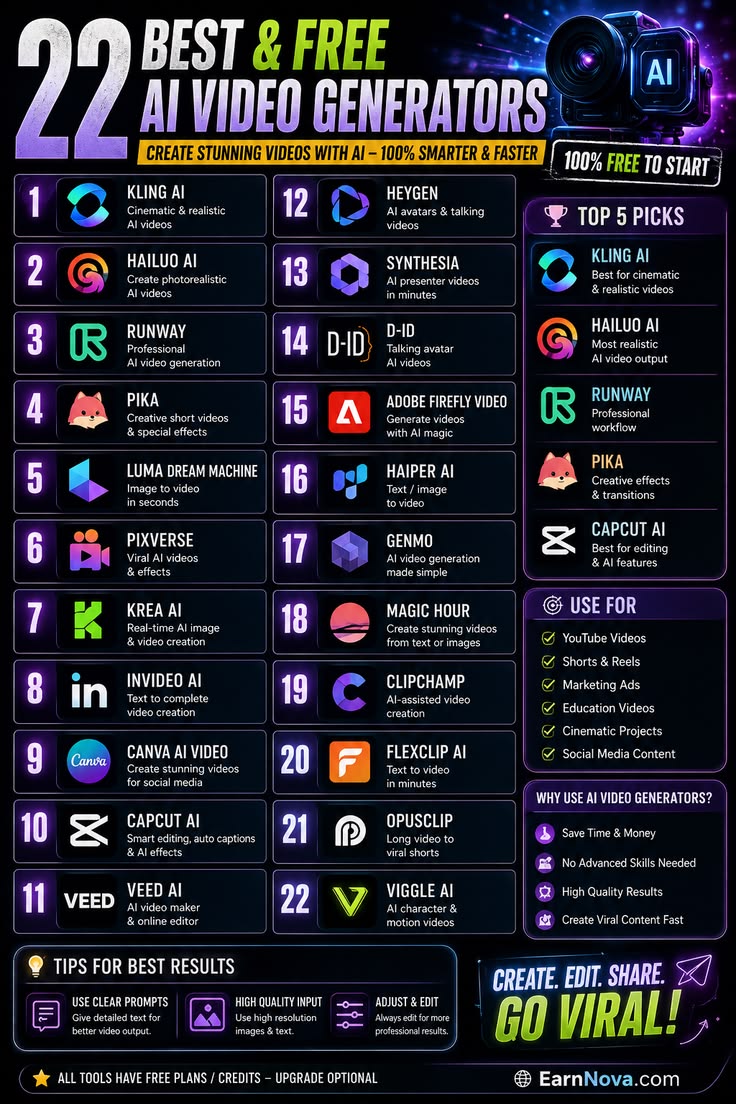
- رسوم معلوماتية لمقارنة الأدوات وترتيبها، بواجهات قوائم عمودية: توجد بكثرة أدلة اختيار تضم شعارات أدوات عدة، مثل «Best Quality vs Best Free» و«22 Best & Free AI Video Generators» [7, 47]. كما تنتمي مخططات خارطة الطريق ومسار التعلم إلى الفئة نفسها [34].
- صور مصغرة تضع شعارات أوأسماء منتجات كبرى مغلقة المصدر في المقدمة: تبرز شعارات Google Gemini/Omni وVeo3 وKling AI وLuma Dream Machine وOpenAI في مواضع لافتة [1, 9, 13, 19, 31, 33, 47]. في المقابل، لا تكاد توجد صور تجعل المصادر المفتوحة، مثل Stable Diffusion وComfyUI وLoRA، موضوعها؛ والبطاقة الوحيدة لـStability AI [49] هي بدورها صورة تجميعية للمنتجات وليست شاشة لسير عمل فعلي.
- تركيب عرض يحول مادة واحدة إلى أساليب متعددة: توجد شبكة مقارنة تحول صورة الشخص نفسها إلى ما يبدو خشبًا محفورًا وأوريغامي وLego وزهورًا، وتعمل كعرض للقدرات التعبيرية لتحرير الصور بالذكاء الاصطناعي [2].
- لقطات مقرّبة للعين وفكرة «لا يمكن تمييزها عن الحقيقة»: مثل لقطة عين من Luma Dream Machine [33] أوإخراج مكبّر للمقارنة بين الذكاء الاصطناعي والإنسان [43]، وهي لغة بصرية تؤكد الواقعية.
- صورة أخبار باستخدام شعارات شركات حقيقية ووثائق إدارية: تظهر صورة لافتة Google [28] ووثائق تبدو متصلة بتشريع ولاية نيويورك [18]، مع كثير من تنسيق «ملخص الأخبار» القائم على الصور المخزنة والنص المتراكب.
دبابيس بارزة
- [1] "AI News: Anthropic Leak Shows Us The Future of AI..." — بنية صورة مصغرة مألوفة في YouTube: «وجه متفاجئ + شعارات شركات التقنية الكبرى، OpenAI/Google/Microsoft». وهي قالب فيديو أخبار الذكاء الاصطناعي بحد ذاته.
- [2] "Google announces ultra-high quality video..."، وهي في الواقع شبكة عرض لتحويل الصور — مقارنة متتابعة تحول مادة من فيديو أصلي إلى أسلوب نحت خشبي وأوريغامي وLego وزخرفة زهرية. مثال نموذجي يوضح بصريًا القدرة التعبيرية لتحرير الصور بالذكاء الاصطناعي.
- [9] "Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API" — يروج لتوليد فيديو سريع مع صوت أصلي باستخدام Veo3 عبر Gemini API؛ مادة دعائية لميزة حديثة مغلقة المصدر.
- [13] "Kling.ai AI-Powered Text-to-Video Generation" — دبوس عمودي يوصي بـKling AI بصيغة «My Top Picks». ويشير إلى ارتفاع الوعي بأداة الفيديو الصينية المغلقة المصدر.
- [19] "Google's Gemini Omni Turns Anything Into Video" — صورة علامة تجارية تضغط التكامل متعدد الوسائط، صورة وصوت ونص إلى فيديو، في أيقونة واحدة.
- [31] "'Amuse 3.0', an AI art creation tool that includes..." — صورة بورتريه شديدة الواقعية لأداة توليد صور تعمل محليًا برعاية AMD؛ واحدة من الحالات القليلة التي تروج للتوليد على الجهاز.
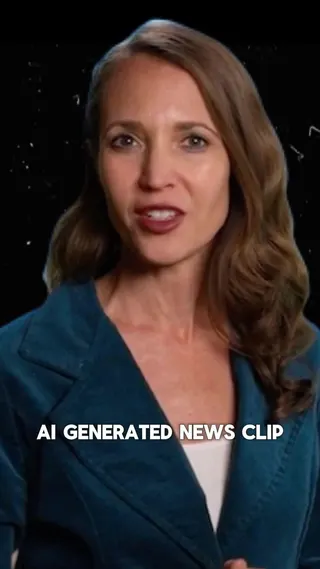
- [32] "AI news videos blur line between real and fake reports" — صورة ثابتة لمذيع مولد بالذكاء الاصطناعي بأسلوب أخبار NBC، وعليها علامة مائية "AI GENERATED". وهي ترمز إلى القلق من إساءة استخدام الذكاء الاصطناعي التوليدي في الأخبار.
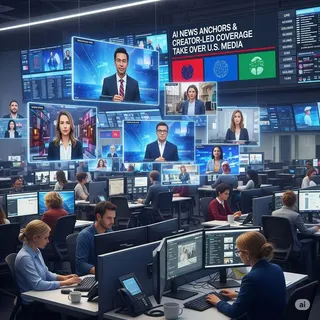
- [44] "AI News Anchors & Creator-Led Coverage Take Over U.S. Media!" — رسم مركب يطل على غرفة أخبار، ويعرض صعود مذيعي الذكاء الاصطناعي والتغطية الإعلامية التي يقودها المبدعون.
- [47] "22 Best & Free AI Video Generators in 2026" — رسم معلوماتي يرتب 22 أداة، منها Kling وHailuo وRunway وPika وLuma. مثال نموذجي لمحتوى اختيار الأدوات الذي يركز على الحصص المجانية.
- [49] "Stability AI's Stable Diffusion Maker Can Now Build AI Generative Video" — تجميعة مرتبطة بـStability AI تضم مشهدًا شبيهًا بمكتب وشاشة كود وأمثلة لبورتريهات مولدة. وهو أحد الأمثلة القليلة للمصادر المفتوحة، لكنه لا يعرض واجهة محددة أواسم نموذج محدد.
الإشارات
- Pinterest الحالي يكاد يكون بلون واحد: فيديو مغلق المصدر: تظهر باستمرار أسماء أدوات تجارية مبنية على API، مثل Veo3/Gemini Omni وKling AI وLuma Dream Machine وRunway، مرفقة بالشعارات. كما تسرد الرسوم المعلوماتية لمقارنة الأدوات [7، 47] أدوات SaaS مغلقة في معظمها؛ إذ يوجد محور المجاني/المفتوح، لكنه ليس في سياق «مفتوح المصدر وتستضيفه بنفسك».
- طلب قوي خاص بـPinterest على «عدم الثقة بالمحتوى المولد بالذكاء الاصطناعي وكيفية تمييزه»: يتشكل نوع مستقل من مواد التوعية حول كشف التزوير وسوء استخدام الأخبار ومقارنات Human or AI؟، وهذا ما يميزه عن المناقشات التقنية في Reddit والمواقع الإخبارية؛ فهو يُستهلك في Pinterest بوصفه «رسومًا معلوماتية توعوية».
- تكاد موضوعات المصادر المفتوحة الخاصة، مثل ComfyUI وLoRA ونماذج OSS الصينية من Wan/HunyuanVideo ونقاشات التراخيص، تكون غائبة. لم يُعثر إلا على مادة واحدة مرتبطة بـStability AI، ولم تُشاهد شاشات سير عمل محددة أوإبداعات مجتمعية.
- لا تتضمن بيانات الجمع مؤشرات التفاعل، مثل عدد الحفظ والإعجابات، لذلك لا يمكن معرفة أي الدبابيس كانت حديث الناس فعليًا من الصور وحدها.
القيود
- فُحصت فعليًا 26 صورة فقط من أصل 50؛ أما الصور الـ24 الباقية فتمت مراجعة عناوينها فقط من
pinterest.pins.md. - جرى جمع Pinterest مسبقًا بواسطة عامل، لذلك لم أُجرِ التصفح بنفسي أوأعدّل استعلام البحث. النتائج ناتجة من استعلام إنجليزي واحد؛ ولم يكن ممكنًا إعادة البحث باستخدام استعلامات يابانية أومرشحات «open source» و«closed source».
- يقتصر الجمع على صور ثابتة، لذلك لم يمكن التحقق من «نتائج متحركة» رغم أن الموضوع هو توليد الفيديو، واقتصرت الاستنتاجات على الصور المصغرة والمواد الدعائية.
- لا تتضمن البيانات مؤشرات تفاعل مثل الحفظ والتعليقات، لذلك لا يمكن تقييم الشعبية أوحجم الانتشار.
الإجراءات الموصى بها
- افحص أسبوعيًا منظومة ComfyUI حول Qwen-Image-2.1 وMinimax H3.
- أوقف الاعتماد على اتجاهات المناطق عند جمع X، وأعد البحث بكلمات تستهدف الذكاء الاصطناعي لتوليد الصور والفيديو مباشرة.
- تابع إعادة ترتيب لاعبي الفيديو المغلقين، Veo وKling وGrok وRunway وSeedance، بعد إغلاق Sora.
- استخدم Pinterest مرجعًا للغة البصرية، لا لقياس الشعبية، بسبب غياب مؤشرات حجم الاهتمام.
- استمر في مراقبة انتشار عدم الثقة بالمحتوى المولد بالذكاء الاصطناعي ونقاشات إلزام العلامات المائية.
- عند إعادة جمع بيانات Reddit، استخدم عبارات بحث مخصصة للمصادر المفتوحة والمغلقة، واقترب من معيار الإتمام البالغ 20 عنصرًا.
الصور المجمعة






























ملاحظات جودة البيانات
حقق X صفر منشورات ذات صلة بسبب خطأ تحديد الموقع الجغرافي والبحث المعتمد على كلمات الاتجاهات؛ وانحاز Bluesky إلى مقالات حساب واحد بسبب خطأ 403 في واجهة البحث؛ ولا يقدم Pinterest مؤشرات تفاعل؛ وتعذر جلب مشاهدات YouTube؛ وتتركز معلومات المصادر المفتوحة في Lemmy عمليًا في مجتمع واحد؛ كما بقي Reddit عند 12 سلسلة دون معيار الإتمام البالغ 20.