كمّمت نموذج لغة كبيرًا من صنعي يضم 300 مليون معلَمة، وقارنت السرعة والدقة على المعالج المركزي
نموذج يضم 320 مليون معلَمة للـRAG باللغة الكرواتية، صنعته في المقال السابق. بما أنه مخصص للعمل على المعالج المركزي، جرّبت هذه المرة تكميمه لمعرفة إلى أي حد يمكن تصغيره وتسريعه، ومقدار ما قد يفقده من دقة.
الخلاصة أولًا.
- Q6_K هو الخيار الأنسب. حجمه خُمس الحجم الأصلي (254MB)، والتوليد أسرع بنحو 4 مرات، والدقة مماثلة للنموذج الأصلي
- Q2_K يتعطل. إنه سريع، لكنه يبدأ بالقول «لا توجد إجابة» حتى للأسئلة التي لها إجابة
- وعلى نحو مفاجئ، كان Q3_K_M أدق من Q4_K_M
ما الذي فعلته
حوّلت النموذج المصنوع في PyTorch إلى صيغة (GGUF) يمكن تشغيلها عبر llama.cpp، المستخدمة كثيرًا للاستدلال على المعالج المركزي، ثم حفظته بثمانية مستويات دقة.
- صدّرت النموذج بالصيغة نفسها الخاصة بـQwen3، ثم حوّلته إلى GGUF
- لأن المُجزّئ من صنعي، رفض llama.cpp التحويل باعتباره «مُجزّئًا غير معروف». قارنت قواعد فصل الكلمات، فوجدتها مطابقة حرفيًا لـQwen2، فسجلته باسم Qwen2 ليمر التحويل
- تحققت من صحة التحويل. تطابق تقسيم الرموز في 160 نصًا بالكامل مع نسخة PyTorch. وعلى 20 سؤالًا، جعلت النموذج يختار في كل مرة الكلمة ذات الاحتمال الأعلى، فتطابقت المخرجات تمامًا في الأسئلة العشرين كلها
- أنشأت صيغ F16 إلى Q2_K باستخدام
llama-quantize
لذلك فإن F32 في الجدول يحمل المحتوى نفسه لنسخة PyTorch. وهو معيار المقارنة هنا.
طريقة القياس
- المعالج هو i7-13700K، ولم أستخدم GPU
- إعدادات llama.cpp: 8 خيوط للتوليد و16 خيطًا لقراءة النصوص (كانت الأسرع في الاختبار)
- جعلت كل نموذج يجيب 400 مرة، باستخدام 100 سؤال × 4 أنواع من السياق
- فقرة: فقرة بنحو 100 رمز تحتوي الإجابة
- نص طويل: نص بنحو 3,000 رمز يحتوي الإجابة (مع مقالات غير مرتبطة أيضًا)
- لا إجابة (فقرة/نص طويل): نص لا يحتوي الإجابة. يكون الرفض صحيحًا هنا
- قاس المقال السابق 300 سؤال، لذلك قد تختلف الأرقام قليلًا
النتائج: الدقة
| الصيغة | الحجم | إجابة صحيحة: فقرة | إجابة صحيحة: نص طويل | رفض النص الطويل | اختلاق (لا إجابة: فقرة/نص طويل) | معدل الدقة بعد التحقق |
|---|---|---|---|---|---|---|
| F32 (المعيار) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
«معدل الدقة بعد التحقق» هو نسبة الإجابات الصحيحة من بين الإجابات التي قدّمها النموذج، بعد التحقق برمجيًا من أن الاقتباس الذي أورده موجود فعلًا في النص واستبداله بـ«لا إجابة» إن لم يكن موجودًا.
- F16 وQ8_0 وQ6_K تكاد تطابق المعيار. الفارق سؤال أو سؤالان فقط
- بدءًا من Q5_K_M وما دونه، يزداد الرفض بدلًا من زيادة الأخطاء. يبدو أن السلوك الذي علّمته سابقًا، وهو الرفض عند انعدام الثقة، يظهر هنا كما هو. ولم تزداد الاختلاقات
- Q4_K_M أسوأ من Q3_K_M. 37% مقابل 48% في النصوص الطويلة. قد يوجد بعض التذبذب لأن العدد 100 سؤال، لكن 11 نقطة فارق كبير. لم أبحث السبب بعد
- Q2_K يرفض 78% من النصوص الطويلة. إنه عمليًا نموذج مختلف
النتائج: السرعة
| الصيغة | سرعة التوليد | متوسط زمن المرة الواحدة |
|---|---|---|
| PyTorch fp32 (للمرجع) | فقرة 14.6・نص طويل 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 ثانية |
| F16 | 35.9 tok/s | 2.08 ثانية |
| Q8_0 | 59.0 tok/s | 1.93 ثانية |
| Q6_K | 73.1 tok/s | 1.33 ثانية |
| Q5_K_M | 81.2 tok/s | 1.26 ثانية |
| Q4_K_M | 89.1 tok/s | 1.10 ثانية |
| Q3_K_M | 103.4 tok/s | 1.12 ثانية |
| Q2_K | 119.9 tok/s | 1.07 ثانية |
أرقام llama.cpp هي متوسط 400 تشغيل (تجمع الفقرات والنصوص الطويلة وحالات عدم وجود إجابة). أما أرقام PyTorch فهي المقاسة في المقال السابق.
- سرعة التوليد تتناسب عكسيًا تقريبًا مع الحجم. على المعالج المركزي، تحددها سرعة قراءة الأوزان من الذاكرة أكثر من الحسابات، لذا يكون النموذج الأصغر أسرع
- حتى مع F32 نفسه، llama.cpp أسرع من PyTorch
- لكن بدءًا من Q6_K وما دونه، لا يتقلص زمن التشغيل الواحد كثيرًا. عند هذا الطول، يصبح وقت قراءة النص أولًا هو الجزء الأكبر
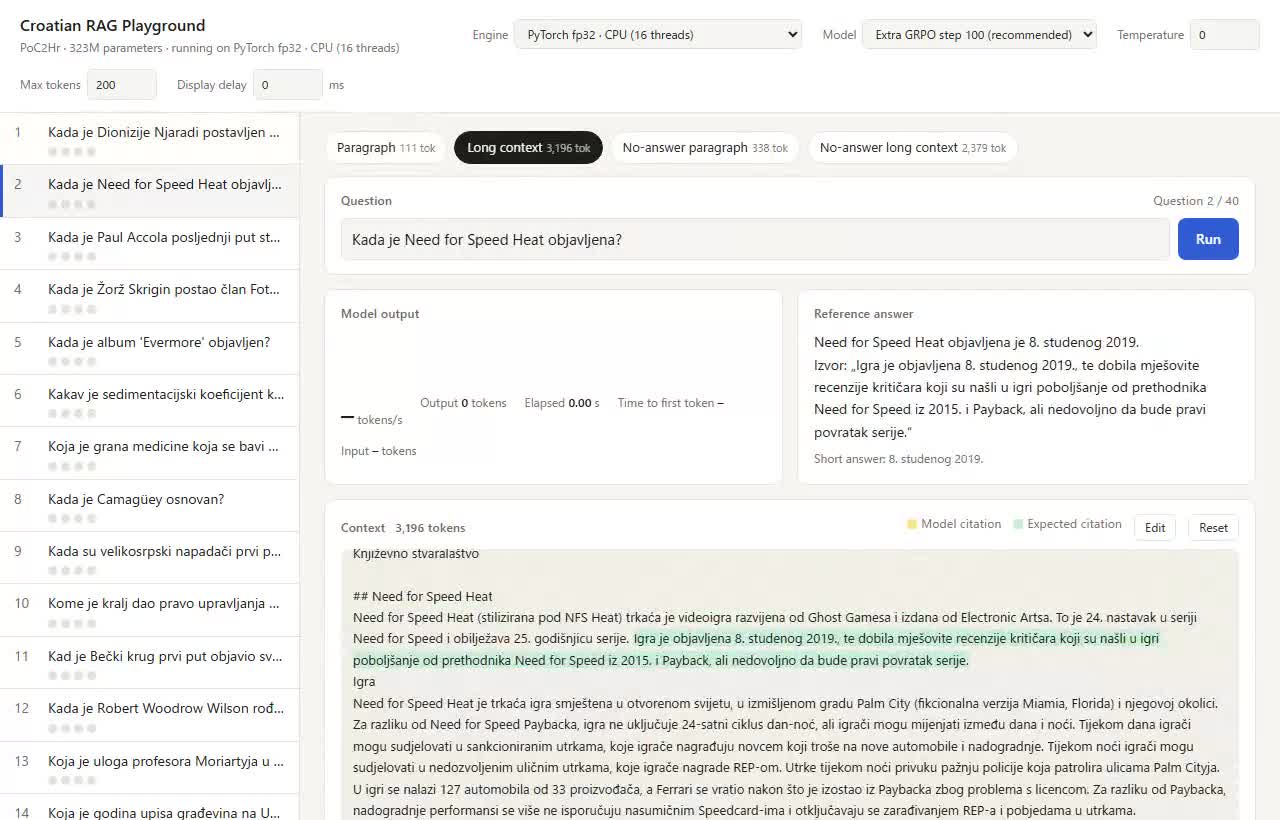
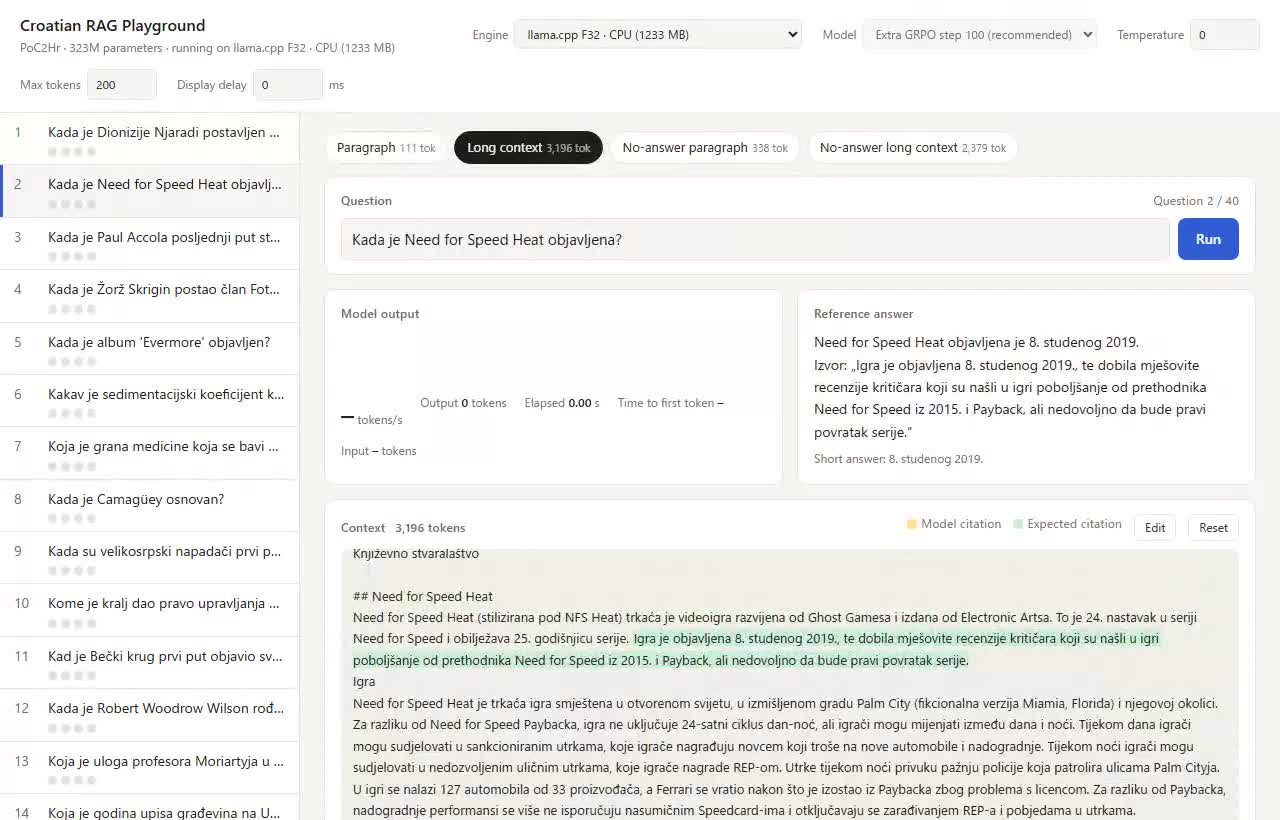
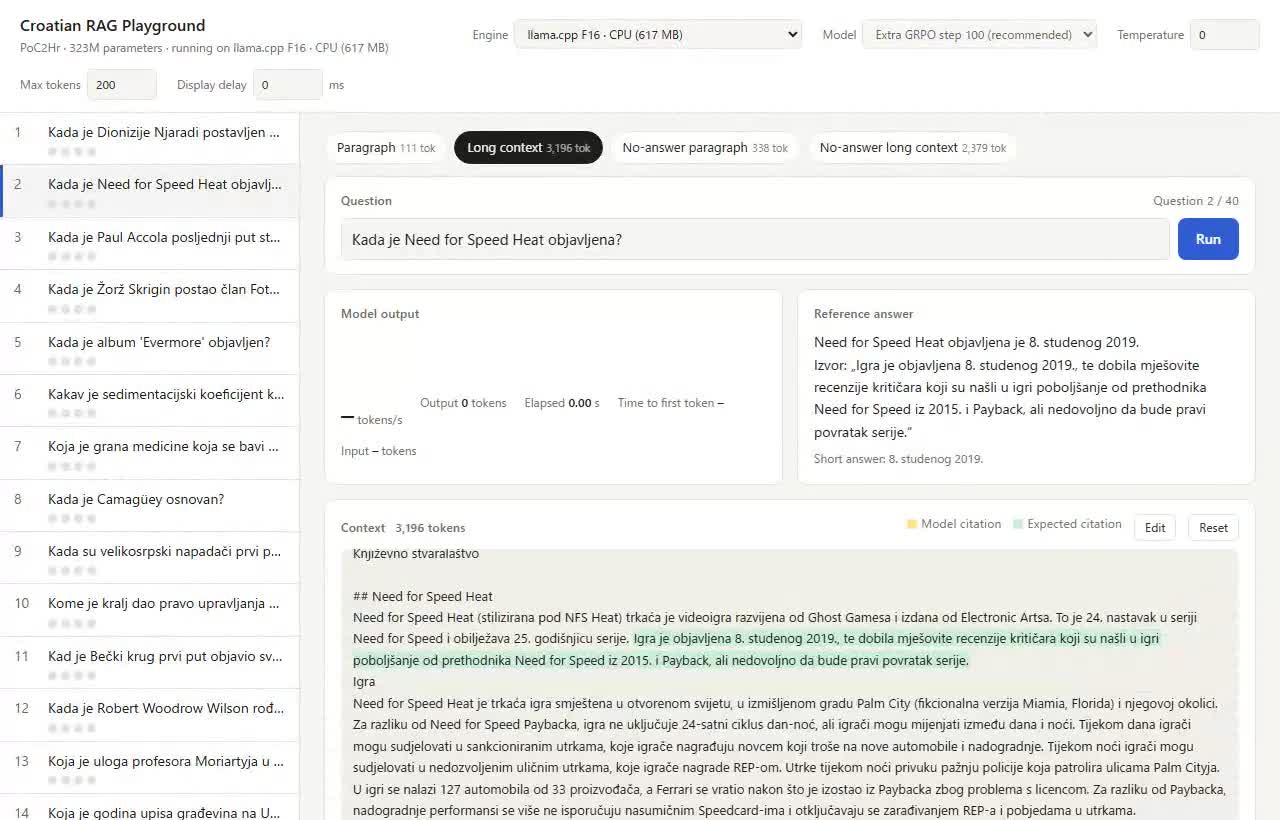
فيديو: حل السؤال نفسه ضمن نص طويل على المعالج المركزي
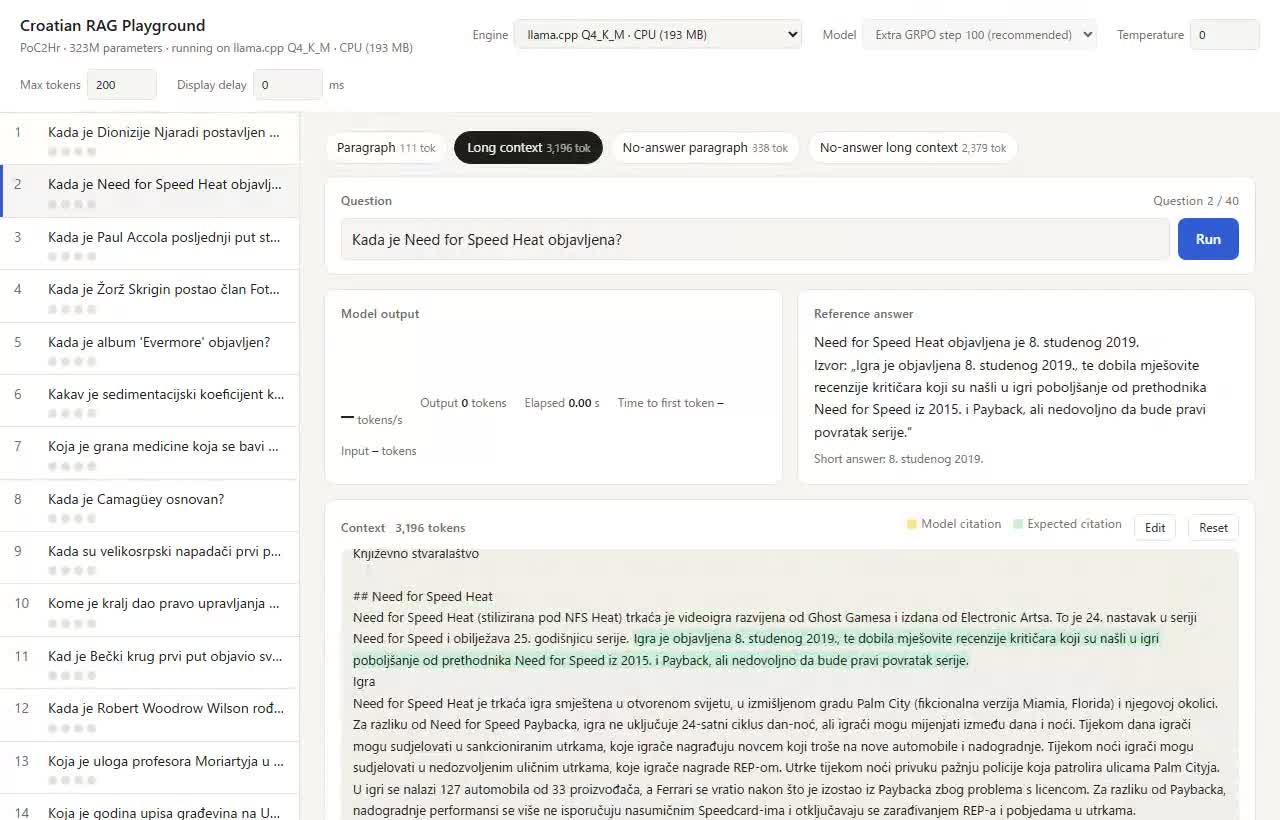
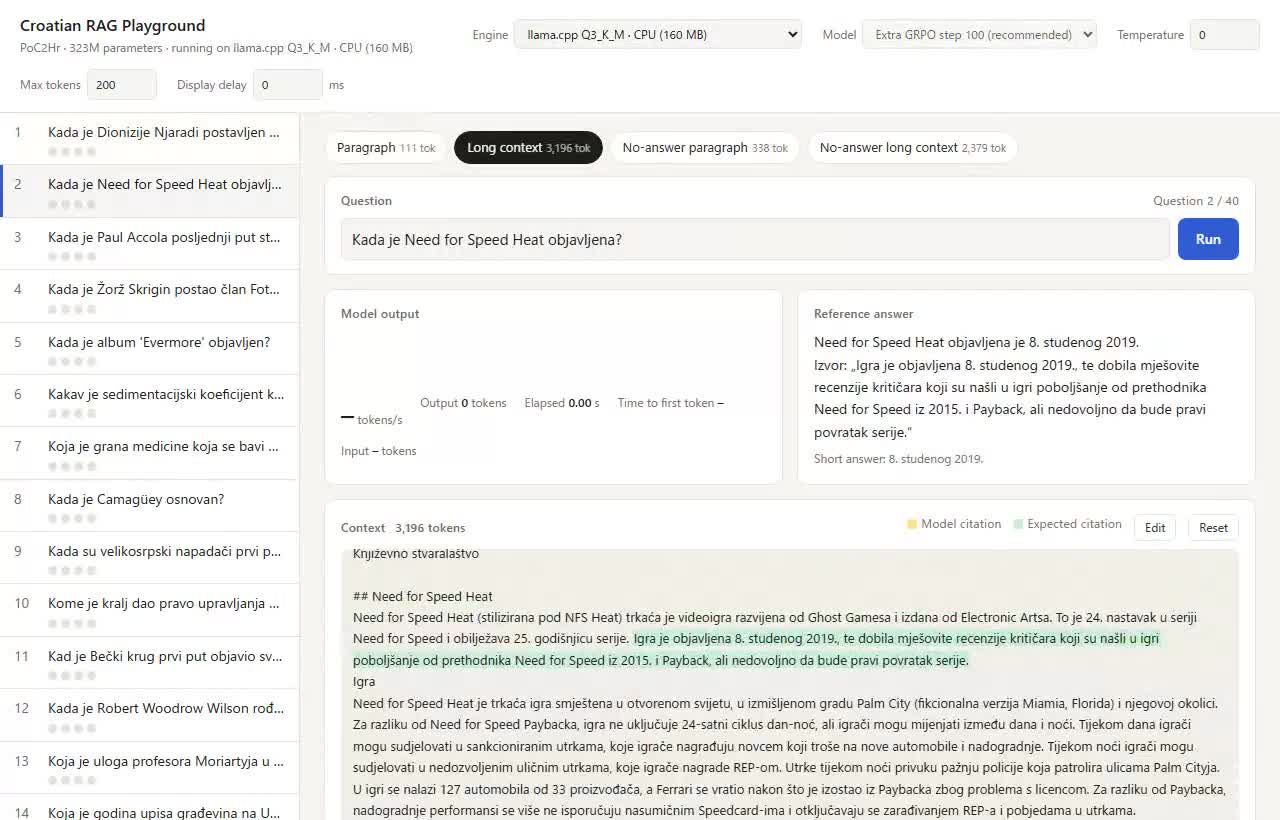
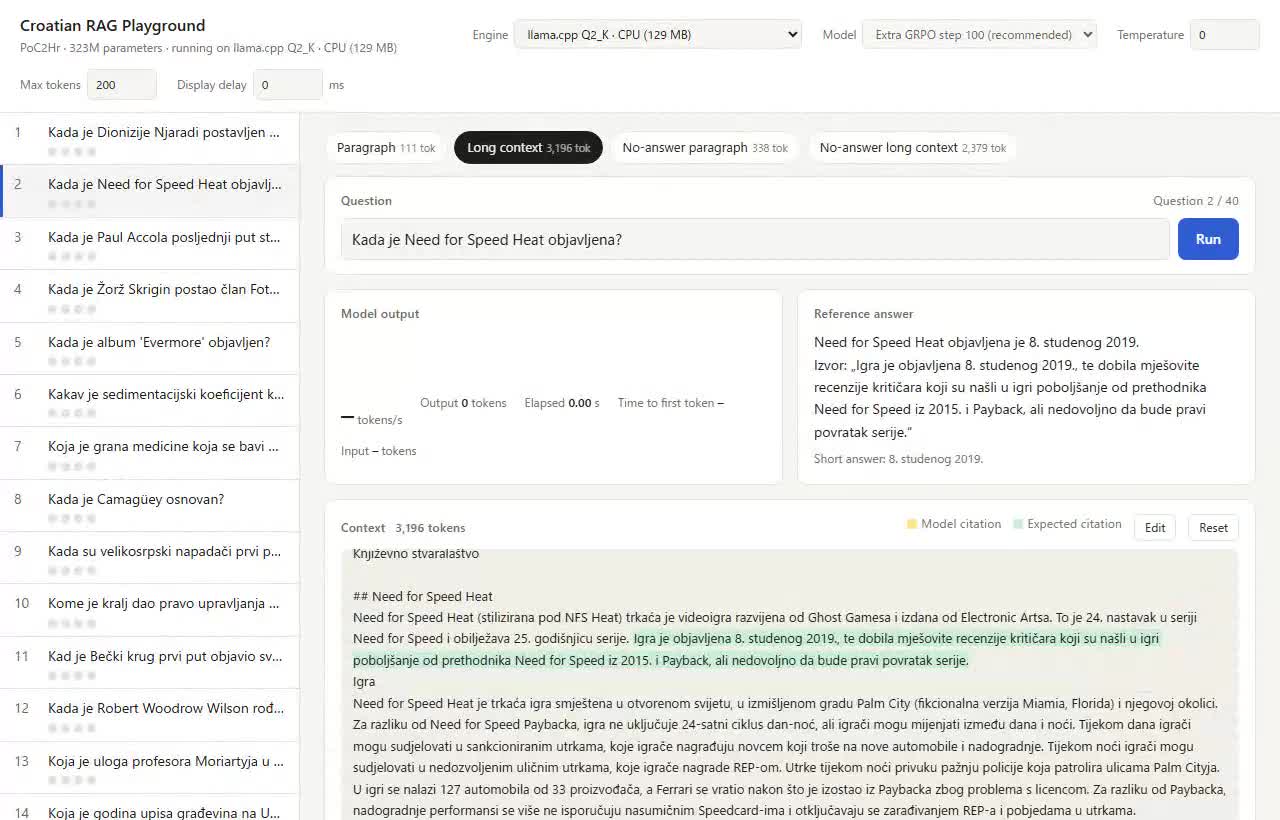
قدمت للنموذج نصًا بنحو 3,200 رمز وسألته: «متى صدرت Need for Speed Heat؟». الإجابة الصحيحة هي 8 نوفمبر 2019.
سجلت الشاشة أثناء التشغيل، وكان المتصفح يرسم الواجهة أيضًا، لذا فالسرعات في الفيديو أبطأ من الجدول أعلاه. انظر إليه للمقارنة جنبًا إلى جنب.
| الصيغة | سرعة التوليد في الفيديو | حتى الحرف الأول | الإجمالي | النتيجة |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 ثانية | 18.5 ثانية | صحيح |
| F32 | 14.2 tok/s | 2.8 ثانية | 8.1 ثانية | صحيح |
| F16 | 25.9 tok/s | 3.5 ثانية | 6.4 ثانية | صحيح |
| Q8_0 | 38.2 tok/s | 4.0 ثانية | 5.9 ثانية | صحيح |
| Q6_K | 41.6 tok/s | 2.6 ثانية | 4.4 ثانية | صحيح |
| Q5_K_M | 46.3 tok/s | 2.6 ثانية | 4.3 ثانية | صحيح |
| Q4_K_M | 47.2 tok/s | 2.3 ثانية | 4.7 ثانية | صحيح (إجابة أطول) |
| Q3_K_M | 56.7 tok/s | 2.5 ثانية | 4.5 ثانية | صحيح (إجابة أطول) |
| Q2_K | 61.3 tok/s | 2.7 ثانية | 2.8 ثانية | رفض |
من F32 حتى Q5_K_M، كانت الإجابة والاقتباس مطابقين حرفيًا لنسخة PyTorch. أصبح نص الإجابة أطول في Q4_K_M وQ3_K_M، لكن الاقتباس كان صحيحًا. أما Q2_K فقال: «لا توجد إجابة في النص» رغم وجود الإجابة.
PyTorch fp32 (النموذج الأصلي)
llama.cpp F32 (1,233MB)
llama.cpp F16 (617MB)
llama.cpp Q8_0 (329MB)
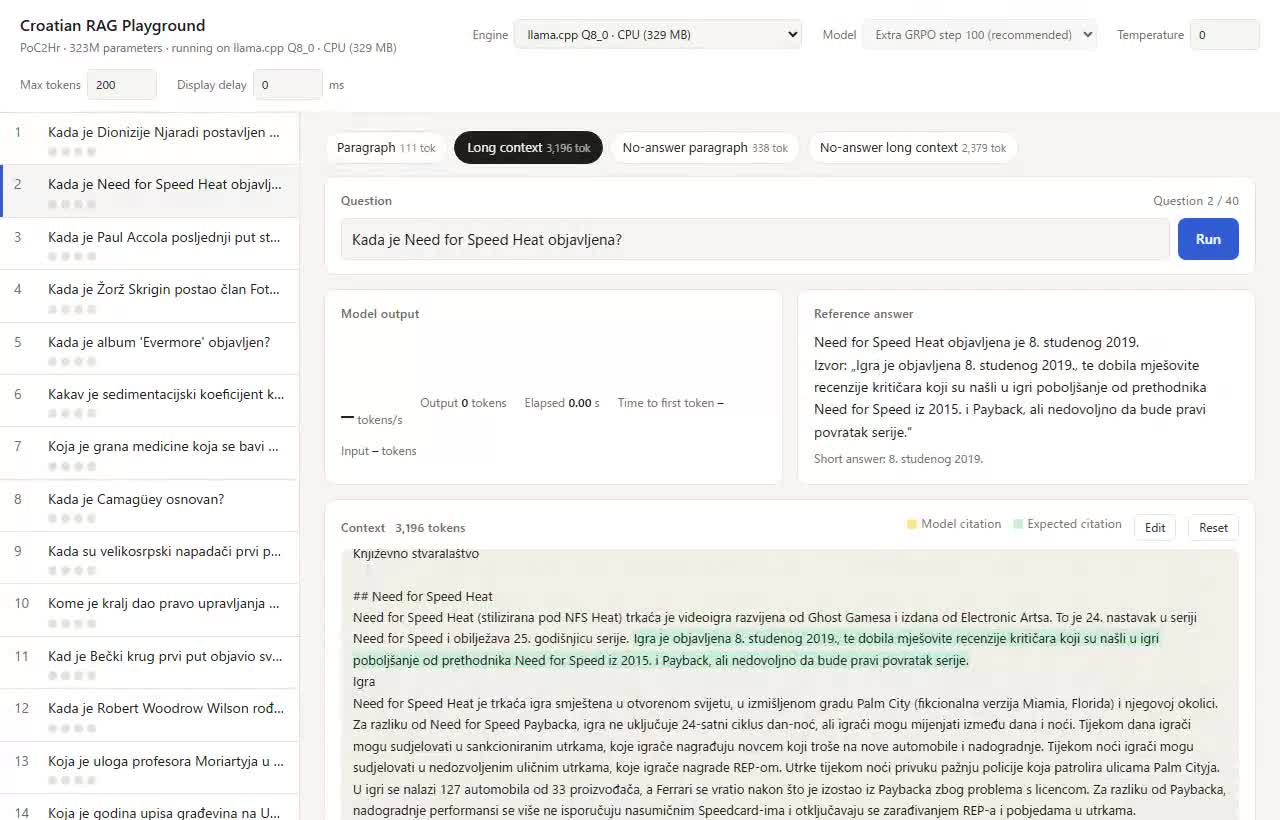
llama.cpp Q6_K (254MB)
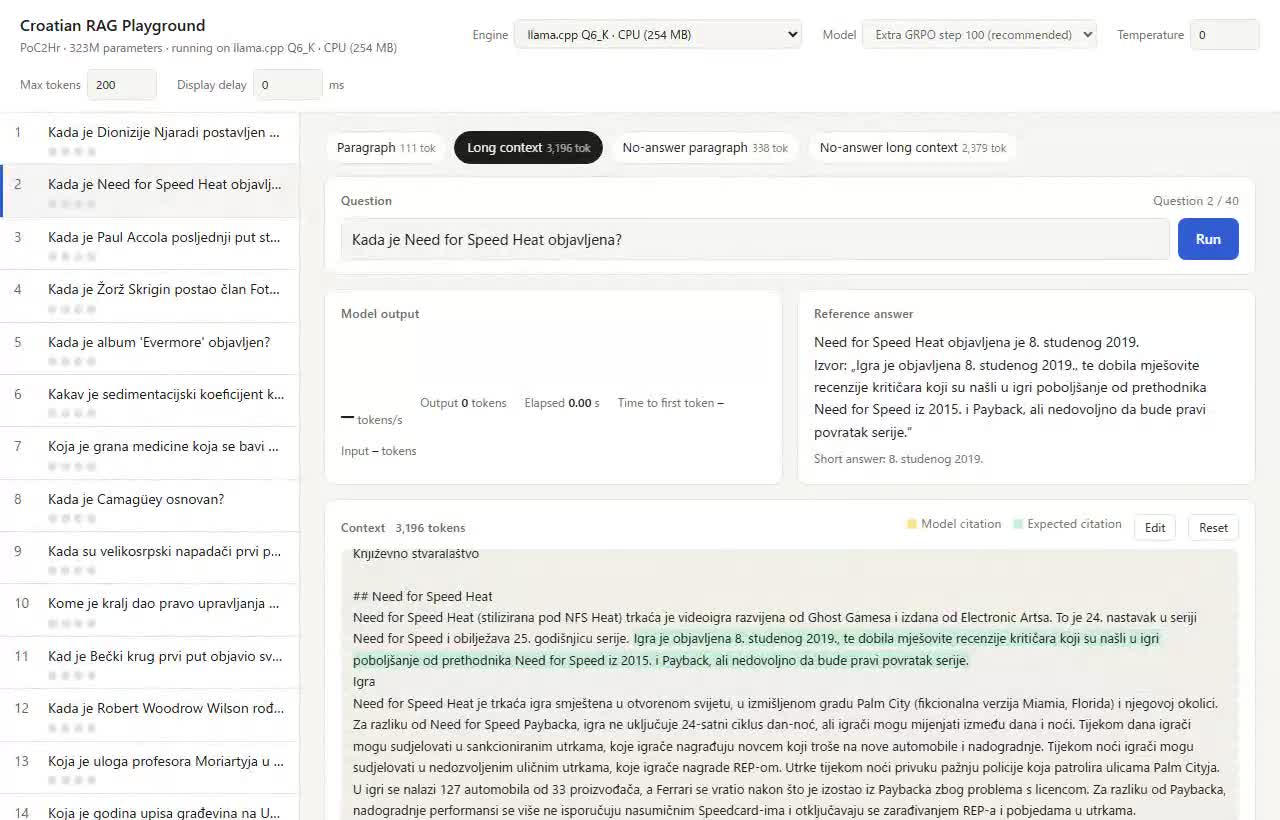
llama.cpp Q5_K_M (223MB)
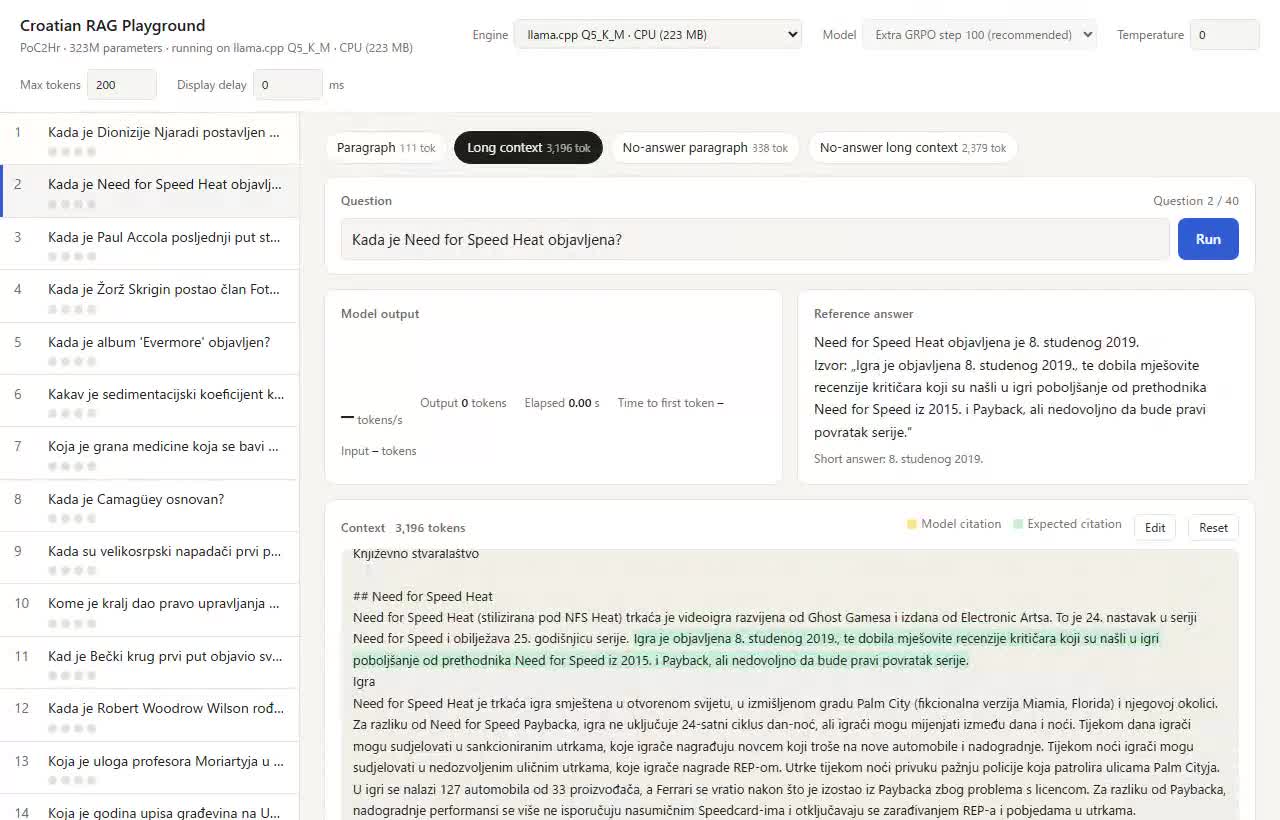
llama.cpp Q4_K_M (193MB)
llama.cpp Q3_K_M (160MB)
llama.cpp Q2_K (129MB)
ملاحظات
- إن كنت ستشغّل هذا النموذج على المعالج المركزي، فاختر Q6_K. الدقة كما هي في الأصل، والحجم خُمس الحجم، والتوليد أسرع من PyTorch بنحو 5 مرات. لا يوجد سبب للتردد
- إن أردت قدرًا أكبر من الاطمئنان، فاختر Q8_0. إنه مطابق تقريبًا للأصل وحجمه 329MB فقط، وهو صغير بما يكفي
- النماذج الصغيرة ذات 300 مليون معلَمة حساسة للتكميم. يقال إن النماذج الكبيرة لا تتدهور تقريبًا حتى عند Q4، لكن هنا ظهر التراجع بوضوح بدءًا من Q5. النموذج لا يملك هامشًا كبيرًا أساسًا، لذا يؤثر تقليصه فيه
- من الجيد أن نمط التعطل هو الرفض. في RAG، الرفض أكثر أمانًا من زيادة الاختلاقات. ويظهر هنا أيضًا أثر تعليم النموذج كيفية الرفض عبر التعلم المعزز في المرة السابقة
- في النماذج الصغيرة، يتقلص فارق السرعة المحسوس. من Q6_K فصاعدًا، يبقى وقت قراءة النص حتى إن تسارع التوليد، لذلك لا يختلف الإحساس كثيرًا. وفي الفيديو أيضًا تجمعت Q6_K إلى Q3_K_M حول أربع ثوانٍ
- ما زال سبب خسارة Q4_K_M أمام Q3_K_M غير معروف. أريد التحقق منه بزيادة عدد الأسئلة ودراسة الطبقات التي تُكمَّم وكيفية تكميمها