اختبرت أداء RAG في نماذج اللغة الصغيرة: مقارنة 25 نموذجًا من 1B إلى 9B بالكرواتية والإنجليزية
بعد أن أنشأتُ نموذج RAG كرواتيًا خاصًا بي ووصلتُ إلى مرحلة التكميم، أردت هذه المرة معرفة مدى صلاحية النماذج الصغيرة المتاحة (SLM) للاستخدام في RAG. أضفت نموذجي الخاص ذا 320 مليون معلمة إلى 25 نموذجًا: 10 نماذج من فئة 1B، و8 من فئة 3B، و7 من فئة 7B، وجعلتها تحل المشكلات نفسها بالكرواتية والإنجليزية.
إضافة (في اليوم نفسه): جرّبت أيضًا ثلاثة نماذج صغيرة صُممت خصيصًا لـ RAG (LFM2-1.2B-RAG وPleias-RAG-1B / 350M). النتائج في النصف الثاني من المقال، ضمن «إضافة: جرّبت نماذج مخصصة لـ RAG أيضًا».
الخلاصة أولًا.
- فئة 3–4B باتت تقريبًا بمستوى فئة 8–9B. بلغ معدل الدقة الإجمالي بالكرواتية 90% لدى Qwen3.5 4B وGemma 4 E4B، مقابل 91% لأفضل نموذج، Qwen3.5 9B
- الفارق الحقيقي هو: هل يستطيع النموذج الامتناع عن الإجابة حين لا توجد إجابة؟ قام Phi-4-mini، رغم كونه من أفضل النماذج في الدقة، باختلاق إجابات في 64% من النصوص الطويلة التي لا تحتوي على إجابة
- في الإنجليزية، تكثر النماذج التي تمتنع رغم وجود الإجابة. امتنع OLMo 3 7B في 47% من الفقرات الإنجليزية، وMiniCPM5 2B في 70% منها
- على CPU، تحتاج فئة 7B إلى أكثر من 30 ثانية للسؤال الواحد ذي النص الطويل. أما فئة 1B فتحتاج من 4 إلى 13 ثانية. نموذجي الخاص ذو 320 مليون معلمة احتاج 2.1 ثانية، ودقته تقارب Qwen3.5 0.8B
ما الذي فعلته
المشكلات: أسئلة أُنشئت من ويكيبيديا الكرواتية، كما في المقال السابق. يُقدَّم لكل سؤال أربعة أنواع من النصوص.
- فقرة: فقرة من نحو 100 رمز تحتوي على الإجابة
- نص طويل: نص من نحو 3,000 رمز يحتوي على الإجابة (وتتضمن أيضًا مقالات غير ذات صلة)
- لا إجابة (فقرة / نص طويل): نص لا يحتوي على الإجابة. تُعد الإجابة صحيحة إذا امتنع النموذج بالقول: «لا توجد إجابة في النص»
النسخة الإنجليزية: ترجمتُ المشكلات نفسها إلى الإنجليزية باستخدام EuroLLM-9B. استبعدتُ من اللغتين المشكلات التي اختفت إجابتها في الترجمة أو بقيت بالكرواتية دون ترجمة، وقارنت بين المشكلات نفسها وعددها 260.
التعليمات: قدّمتُ، في كل لغة، تعليمات تقول: «استخدم النص أدناه فقط، وأجب بإيجاز في جملة واحدة. إذا لم توجد إجابة، فأجب فقط: “لا توجد إجابة في النص”».
التقييم: جعلتُ Qwen3.5 9B يقارن بالإجابة النموذجية ويصنّف الإجابة إلى «صحيحة، خاطئة، امتنع». راجعتُ بنفسي 65 حالة، فوجدت أن التقييم متساهل قليلًا، إذ يعد الإجابات الجزئية مثل ذكر السنة فقط صحيحة، لكنه أصاب في جميع أحكامه حول ما إذا كان النموذج قد امتنع أم لا.
معدل الدقة الإجمالي: عدد الإجابات الصحيحة على الفقرات والنصوص الطويلة، مضافًا إليه عدد حالات الامتناع الصحيحة عند غياب الإجابة، مقسومًا على جميع المشكلات. وهو رقم يقيس معًا القدرة على الإجابة الصحيحة والالتزام بالصمت عند عدم المعرفة.
طريقة التشغيل: قست الدقة عبر vLLM على RTX 4090، باستخدام توليد يختار في كل مرة الكلمة ذات الاحتمال الأعلى. عطّلت «وضع التفكير» في النماذج التي تملك هذا النمط من الإجابة بعد التفكير. واستخدمت FP8 لنماذج فئة 7B لتتسع في ذاكرة GPU.
النتائج: الدقة (الكرواتية)
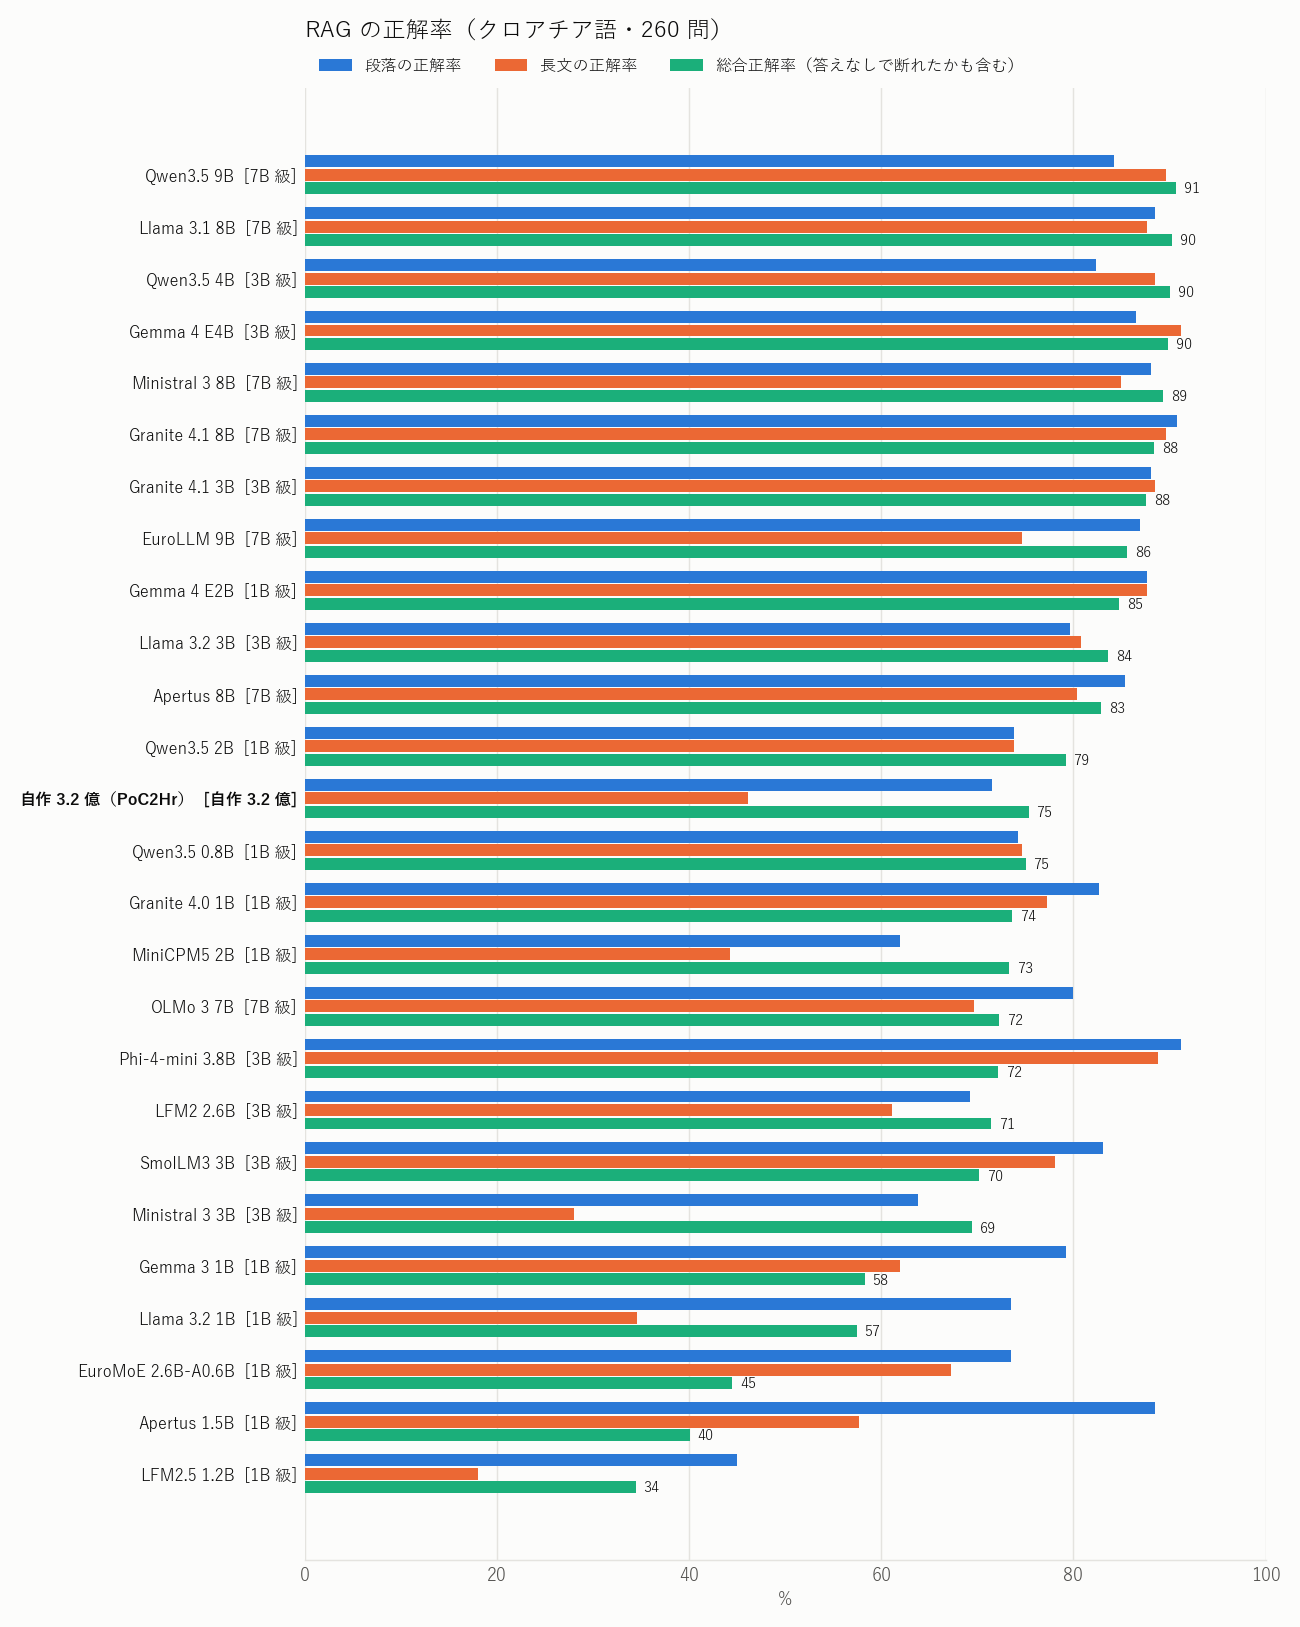
- تتقارب النماذج العليا عند نحو 90%. Qwen3.5 9B (91%)، وLlama 3.1 8B، وQwen3.5 4B، وGemma 4 E4B (90%)
- ضمن فئة 1B، يتفوق Gemma 4 E2B بوضوح (85%). لكن رغم أن اسمه 2B، فإن حجم ملفه كبير نسبيًا ويبلغ 3.2GB
- هناك نماذج تحقق دقة عالية في الفقرات والنصوص الطويلة لكنها تهبط في الإجمالي. حقق Phi-4-mini نسبة 91% في الفقرات و89% في النصوص الطويلة، وهو ضمن المجموعة الأعلى، لكن إجماليه 72%. والسبب هو «الاختلاق» التالي
- الأسوأ كان LFM2.5 1.2B (34%). لم يتمكن من الإجابة على المشكلات التي لها إجابة، واخترع إجابات في المشكلات التي لا إجابة لها
النتائج: الدقة (الإنجليزية)
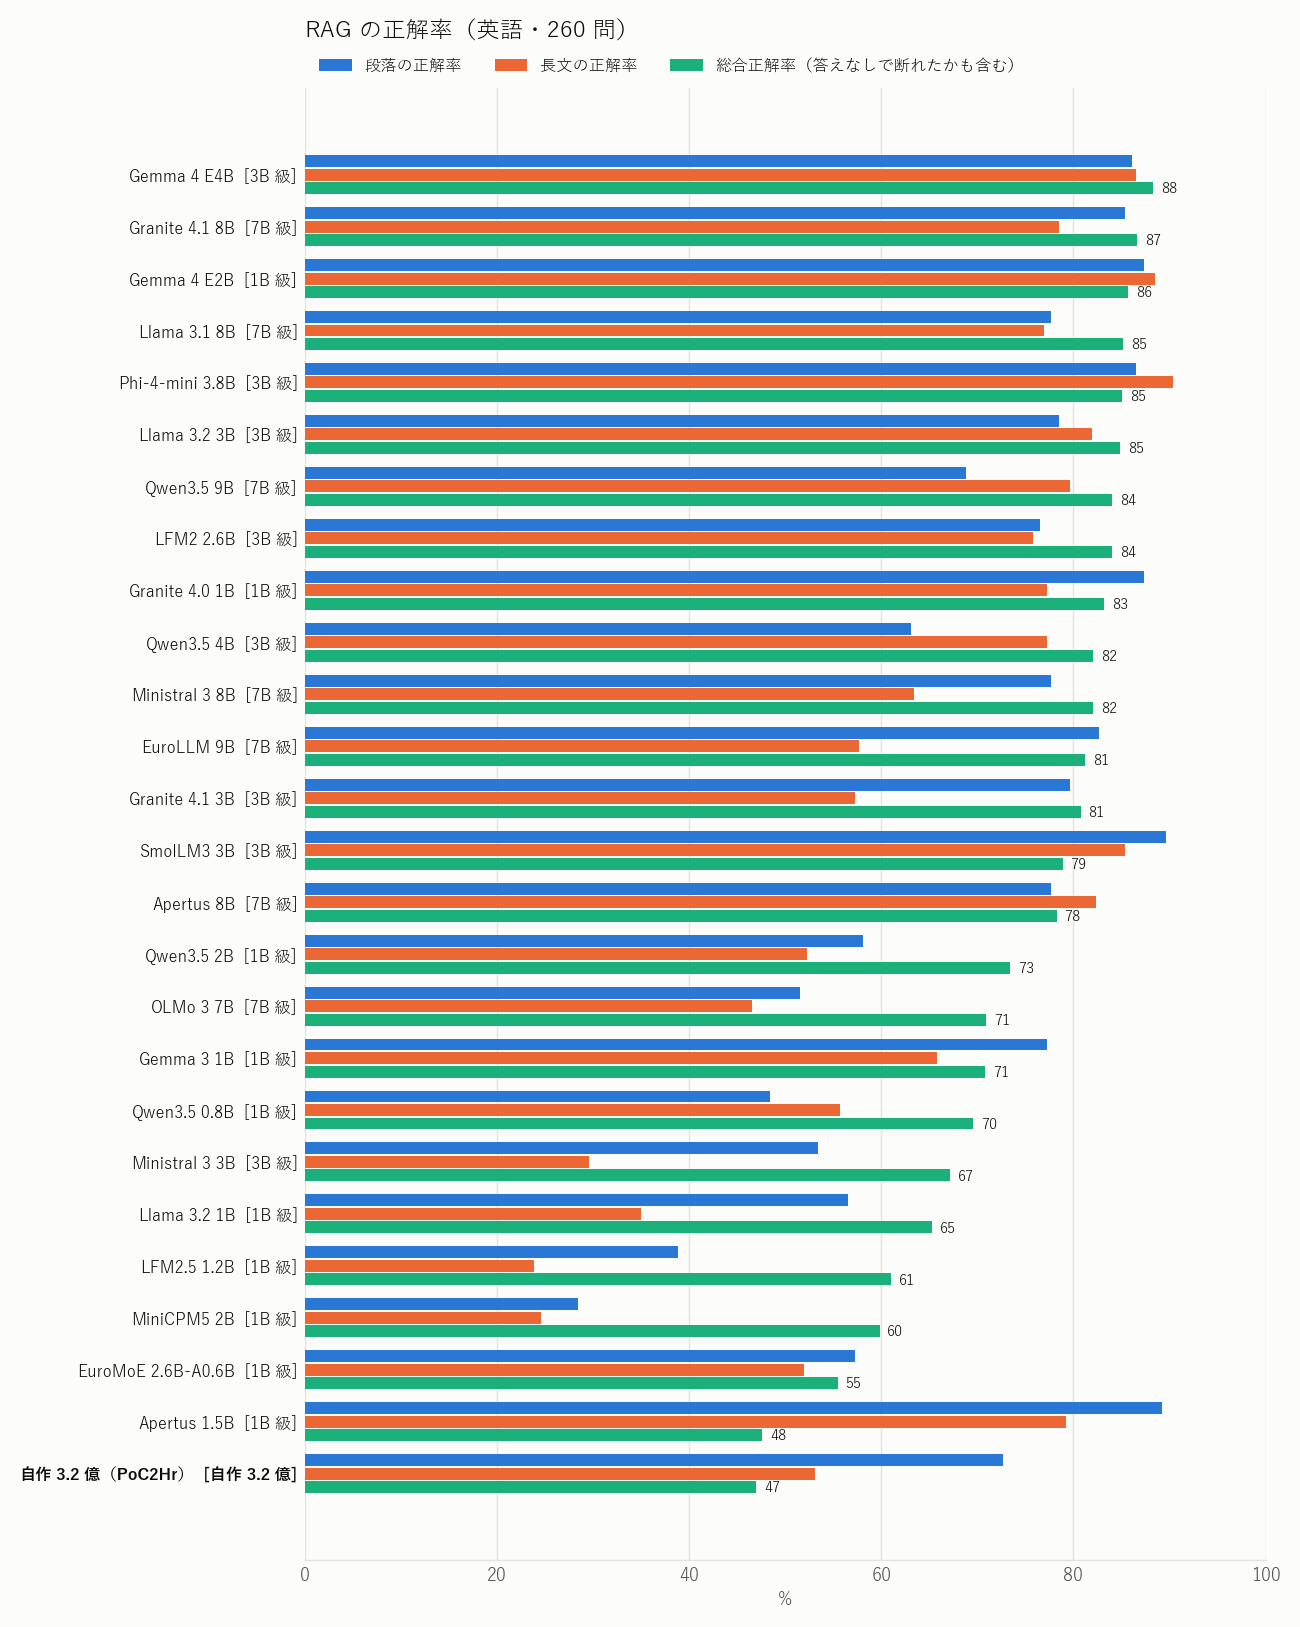
- الأفضل هو Gemma 4 E4B (88%). وحقق Gemma 4 E2B أيضًا 86%، لذا فإن Gemma 4 مستقر في اللغتين
- هناك نماذج يتراجع ترتيبها في الإنجليزية. انتقل Qwen3.5 4B من 90% بالكرواتية إلى 82% بالإنجليزية. والسبب هو الامتناع رغم وجود الإجابة (35% من الفقرات)
ما تعلمته 1: الفارق هو «هل يستطيع الامتناع؟»
نسبة الإجابات المختلقة عند تقديم نص طويل لا يحتوي على الإجابة (بالكرواتية).
| النموذج | الاختلاق في نص طويل بلا إجابة |
|---|---|
| Qwen3.5 4B | 9% |
| نموذجي الخاص 320 مليون | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
على سبيل المثال، عندما سُئل: «متى صدر Need for Speed Heat؟» وقُدم له نص طويل لا يحتوي على الإجابة، أجاب Qwen3.5 9B: «لا توجد إجابة في النص»، بينما أجاب Phi-4-mini: «أغسطس 1969». يبدو أنه التقط تاريخًا ورد في مكان ما من النص.
هذه هي المشكلة الأكبر في RAG. من الخطير اختيار نموذج بالنظر إلى معدل الدقة وحده. كانت نسبة الإجابات الصحيحة من بين الإجابات المقدمة هي الأعلى لدى Qwen3.5 4B و9B، عند 91–92%، بينما لم تتجاوز 64% لدى Phi-4-mini.
ما تعلمته 2: في الإنجليزية، يمتنع كثيرًا أكثر من اللازم
بالمقابل، كان هناك كثير من النماذج في الإنجليزية التي تمتنع رغم أن الإجابة مكتوبة بوضوح. وهذه هي نسبة الامتناع عند تقديم فقرة تحتوي على الإجابة.
| النموذج | الكرواتية | الإنجليزية |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
على سبيل المثال: «متى كان آخر صعود لـ Paul Accola إلى منصة التتويج؟». تذكر الفقرة الإنجليزية بوضوح «the last time in 2000»، لكن Qwen3.5 4B أجاب: «لا توجد إجابة في النص». وعند سؤال المشكلة نفسها بالكرواتية، أجاب بصورة صحيحة: «عام 2000».
لا أعرف السبب بعد. ربما تؤثر صياغة النص غير الطبيعية لأن النسخة الإنجليزية مترجمة آليًا، أو ربما يستجيب بقوة في الإنجليزية لتعليمات «إذا لم توجد إجابة، فأجب هكذا».
النتائج: السرعة على CPU
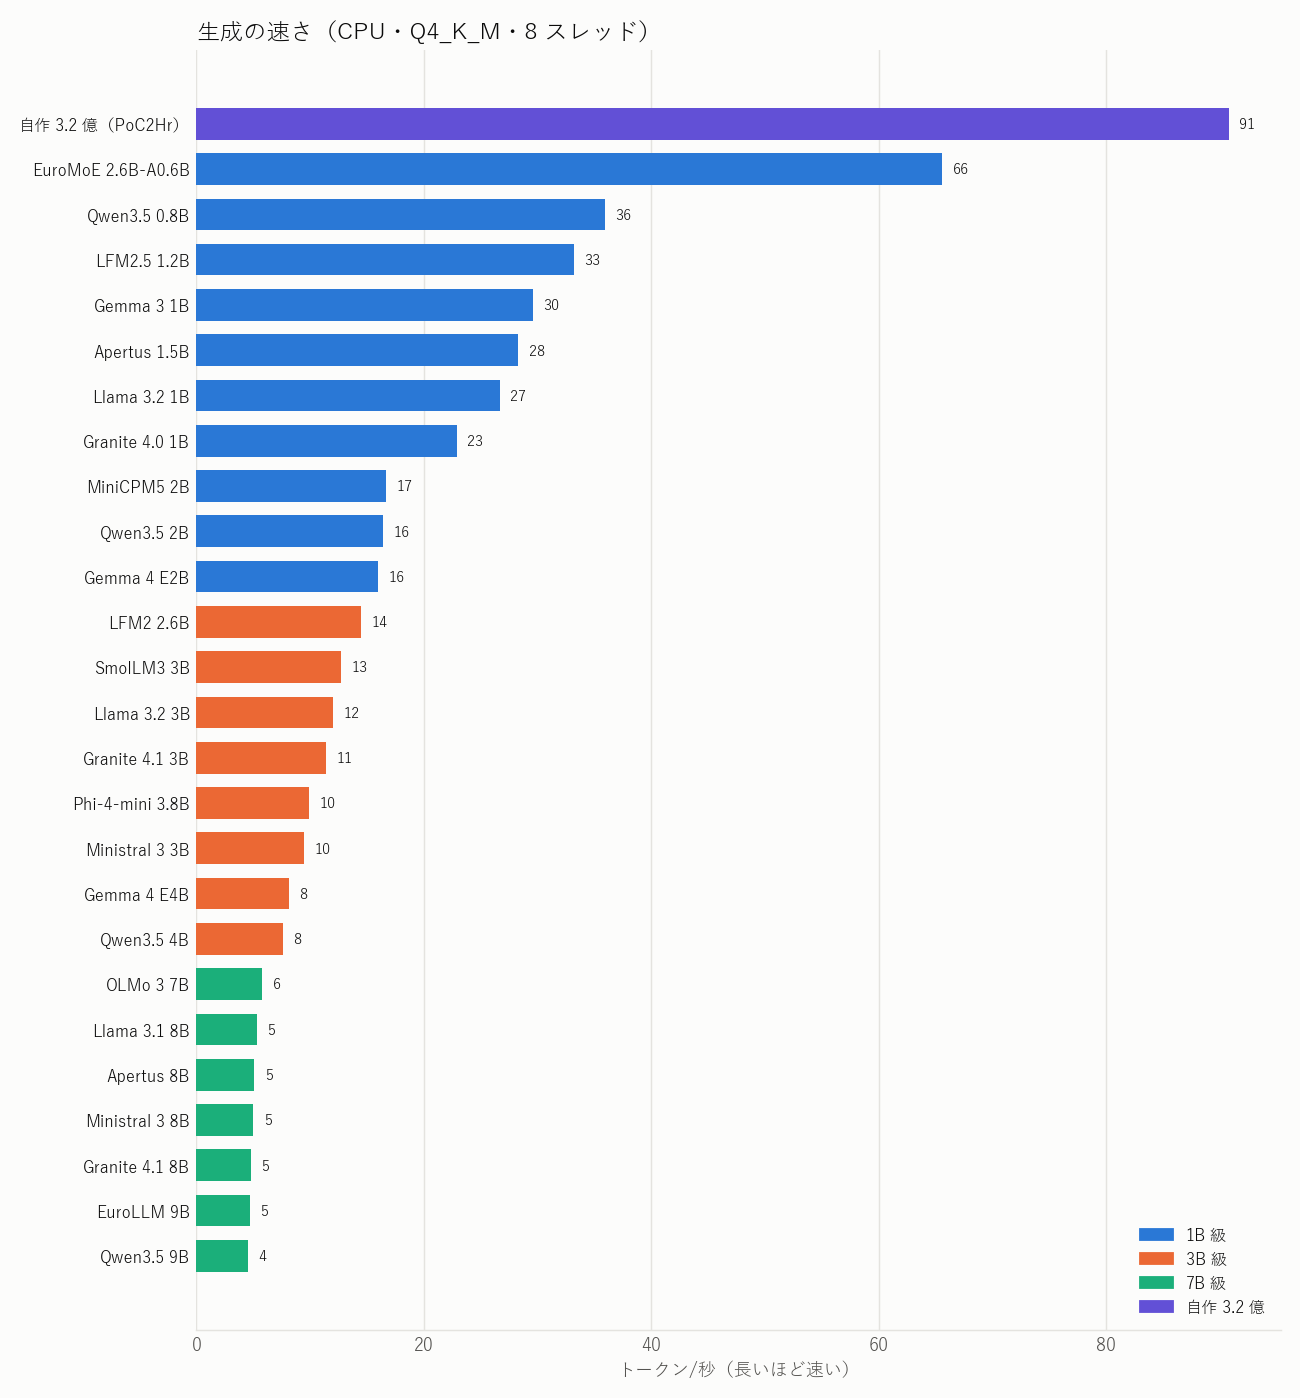
بما أن استخدامي يفترض التشغيل على CPU، حوّلت جميع النماذج إلى التنسيق نفسه في llama.cpp (Q4_K_M)، وقستها على i7-13700K. استخدمت 8 خيوط للتوليد و16 خيطًا لقراءة النص. لم تنجح عملية تحويل Ministral 3 جيدًا، لذا استخدمت Q4_K_M الرسمي من Mistral.
قدّرتُ أيضًا الوقت اللازم للإجابة عن سؤال واحد ذي نص طويل. وهو مجموع وقت قراءة عدد رموز إدخال النص الطويل الخاص بكل نموذج ووقت توليد متوسط طول الإجابة.
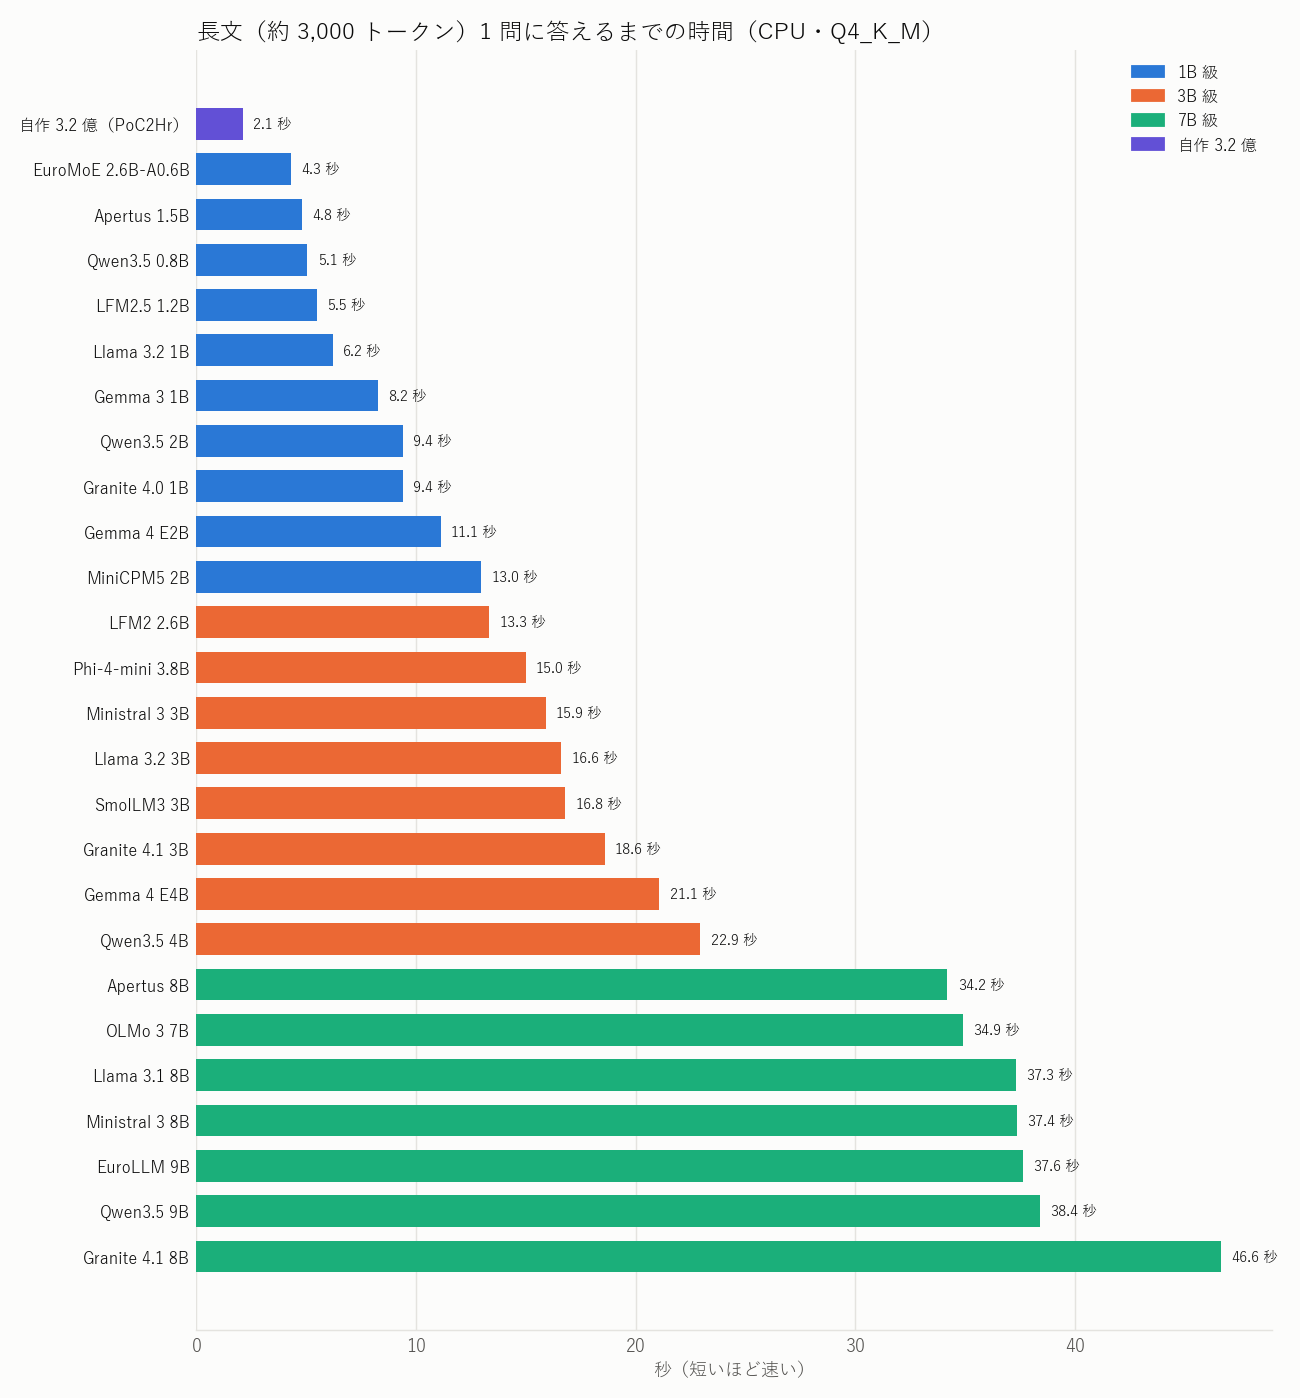
- تتناسب سرعة التوليد، تقريبًا، عكسيًا مع الحجم. تعالج فئة 7B نحو 5 رموز في الثانية، أي 34–47 ثانية للسؤال الواحد ذي النص الطويل
- تحتاج فئة 3B إلى 13–23 ثانية، وفئة 1B إلى 4–13 ثانية
- حتى للنص الطويل نفسه، يختلف عدد رموز الإدخال بين 2,443 و3,796 وفق النموذج. يرجع ذلك إلى مدى قدرة المُرمّز على تمثيل الكرواتية باختصار، والمُرمّز الذي صنعته خصيصًا للكرواتية في نموذجي الخاص هو الأقصر
عند وضع السرعة والدقة جنبًا إلى جنب
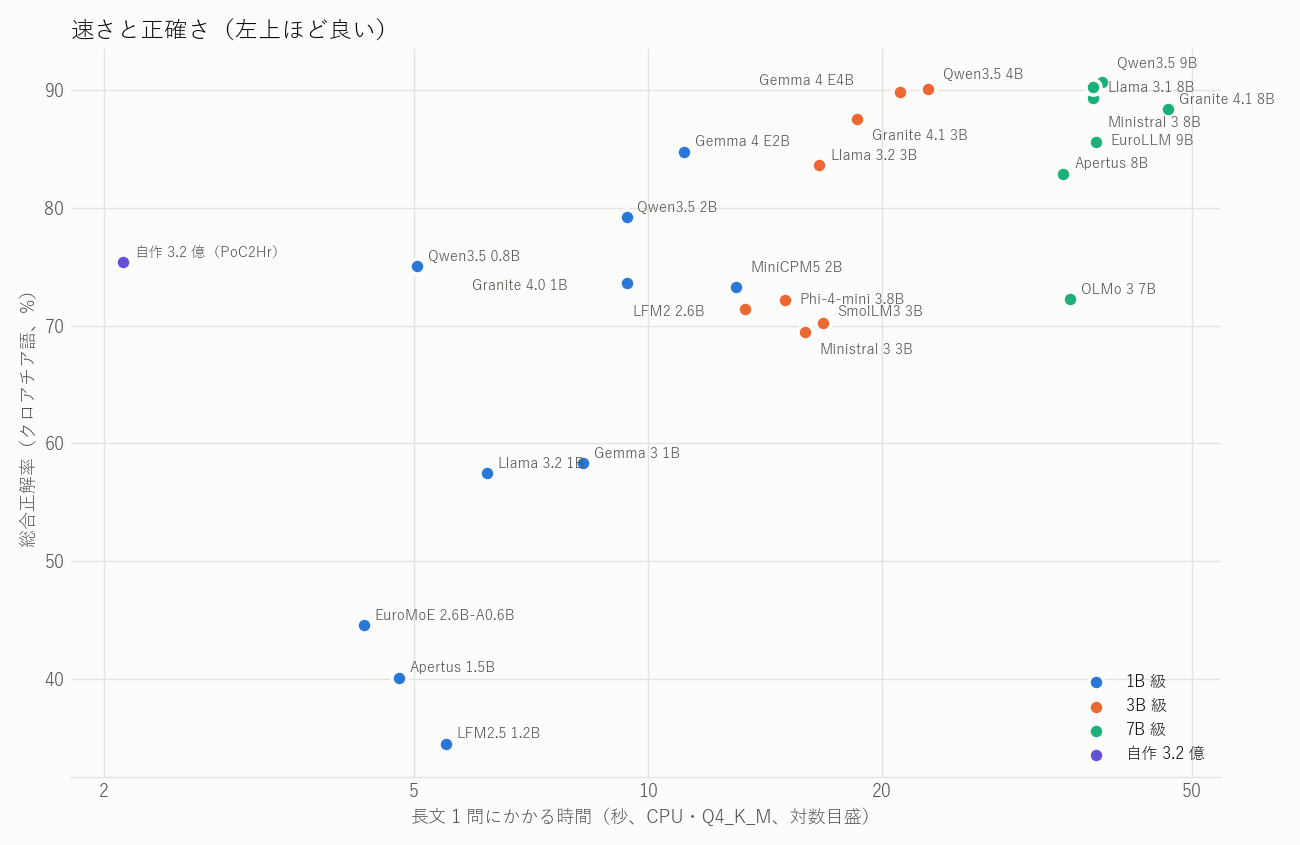
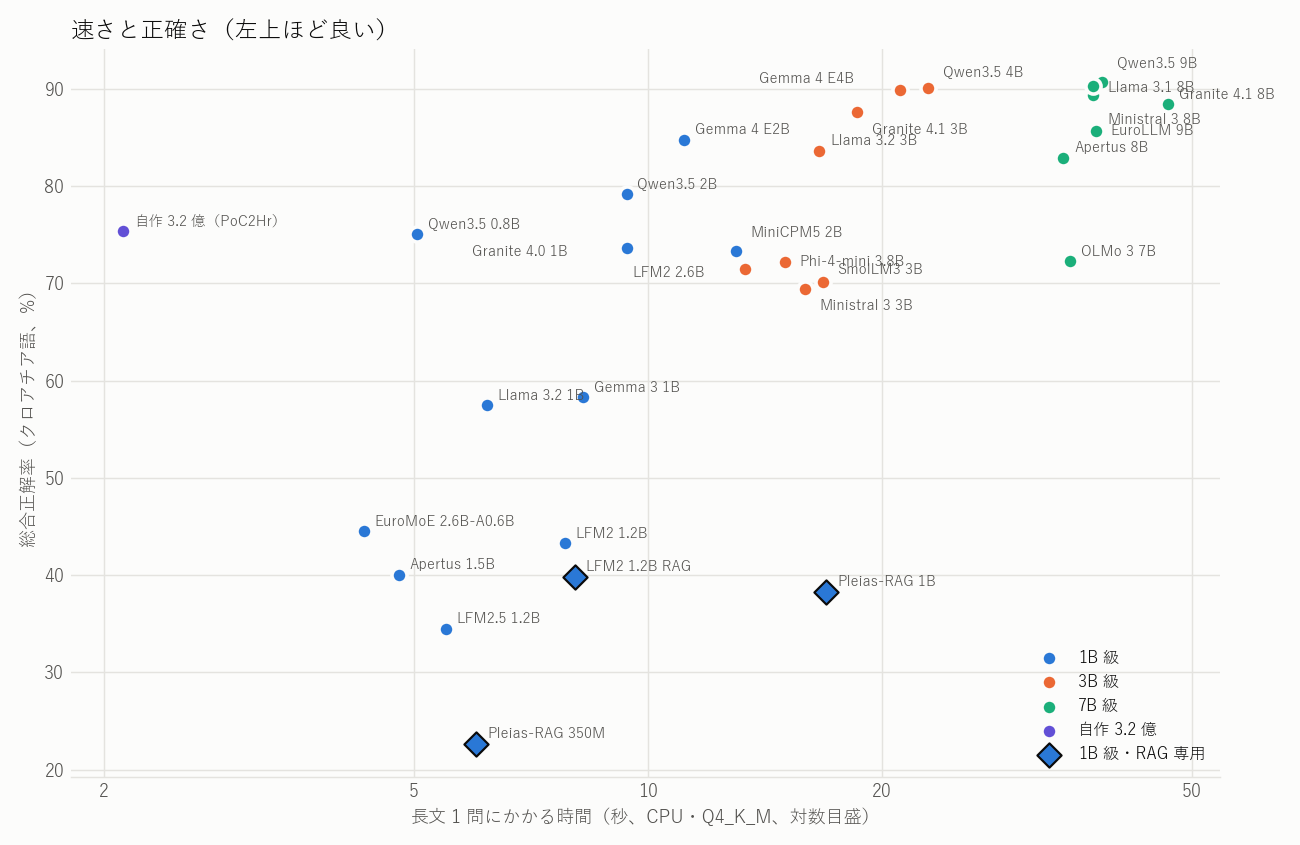
كلما اتجهنا إلى أعلى اليسار، كان النموذج «أسرع وأكثر دقة».
- التوازن الجيد لدى Gemma 4 E2B (11 ثانية، 85%) وQwen3.5 2B (9 ثوانٍ، 79%)
- إذا كانت الأولوية للدقة، فاختر Qwen3.5 4B أو Gemma 4 E4B (21–23 ثانية، 90%). فهما أسرع بأكثر من 1.5 مرة من فئة 7B، ودقتهما متقاربة جدًا
- سرعة نموذجي الخاص ذي 320 مليون معلمة في فئة مختلفة تمامًا (2.1 ثانية). يساوي معدل دقته الإجمالي البالغ 75% معدل Qwen3.5 0.8B، وقلّة اختلاقه تقارب النماذج العليا. لكن دقته في النصوص الطويلة تبلغ 46%، وهي أضعف بوضوح من Qwen3.5 0.8B (75%) وGemma 4 E2B (88%)
- لم يُدرَّب نموذجي الخاص على الإنجليزية، ولذلك اختلق إجابات في 91% من النصوص الطويلة بلا إجابة بالإنجليزية
نقاط يجب الانتباه إليها
- التقييم قائم على LLM، ولذلك ليس مثاليًا. وهو متساهل قليلًا
- النسخة الإنجليزية مترجمة آليًا. أنشأ EuroLLM-9B الأسئلة وترجمها، لذا قد تكون هناك أفضلية طفيفة لـ EuroLLM (لكن نتيجته كانت متوسطة، 86%)
- يدعم Apertus 1.5B سياقًا يصل إلى 4,096 رمزًا فقط، ولم يتسع لـ 23% من النصوص الطويلة الكرواتية. واحتُسبت الحالات التي لم تتسع كإجابات خاطئة
- قيسَت الدقة على GPU (vLLM، وFP8 لفئة 7B)، والسرعة على CPU (Q4_K_M)، لذا تختلف بيئة القياس. وقد يغيّر التكميم الدقة قليلًا
- قست السرعة على حاسوب مفتوح عليه تطبيقاتي المعتادة. قست جميع النماذج تباعًا في الظروف نفسها، لذا أعتقد أنها صالحة للمقارنة
مناقشة
- للاستخدام في RAG، يكفي 4B الآن. أعلى نماذج فئة 3–4B دقيقة بقدر فئة 7–9B، وأسرع على CPU بمقدار 1.5–2 مرة
- عند اختيار النموذج، ينبغي دائمًا التحقق من قدرته على الامتناع. حتى عندما تكون الدقة متقاربة، تتفاوت نسبة الاختلاق في النصوص بلا إجابة بين 1% و99% حسب النموذج. وفي RAG، كثيرًا ما يعثر الاسترجاع على نصوص غير ذات صلة، لذا فهذه النقطة هي الأهم
- يتغير سلوك النموذج نفسه بحسب اللغة. في الإنجليزية، كانت نماذج كثيرة حذرة أكثر من اللازم وفوّتت الإجابة. ولا يمكن معرفة ذلك من دون التجربة الفعلية باللغة المستخدمة
- تحدي نموذجي الخاص هو النصوص الطويلة. قدرته على الامتناع وسرعته كافيتان، وإذا ارتفعت دقته في النصوص الطويلة، فمن المفترض أن يصبح صالحًا جدًا كنموذج RAG يعمل على CPU. هذا ما أريد تحسينه لاحقًا
إضافة: جرّبت نماذج مخصصة لـ RAG أيضًا
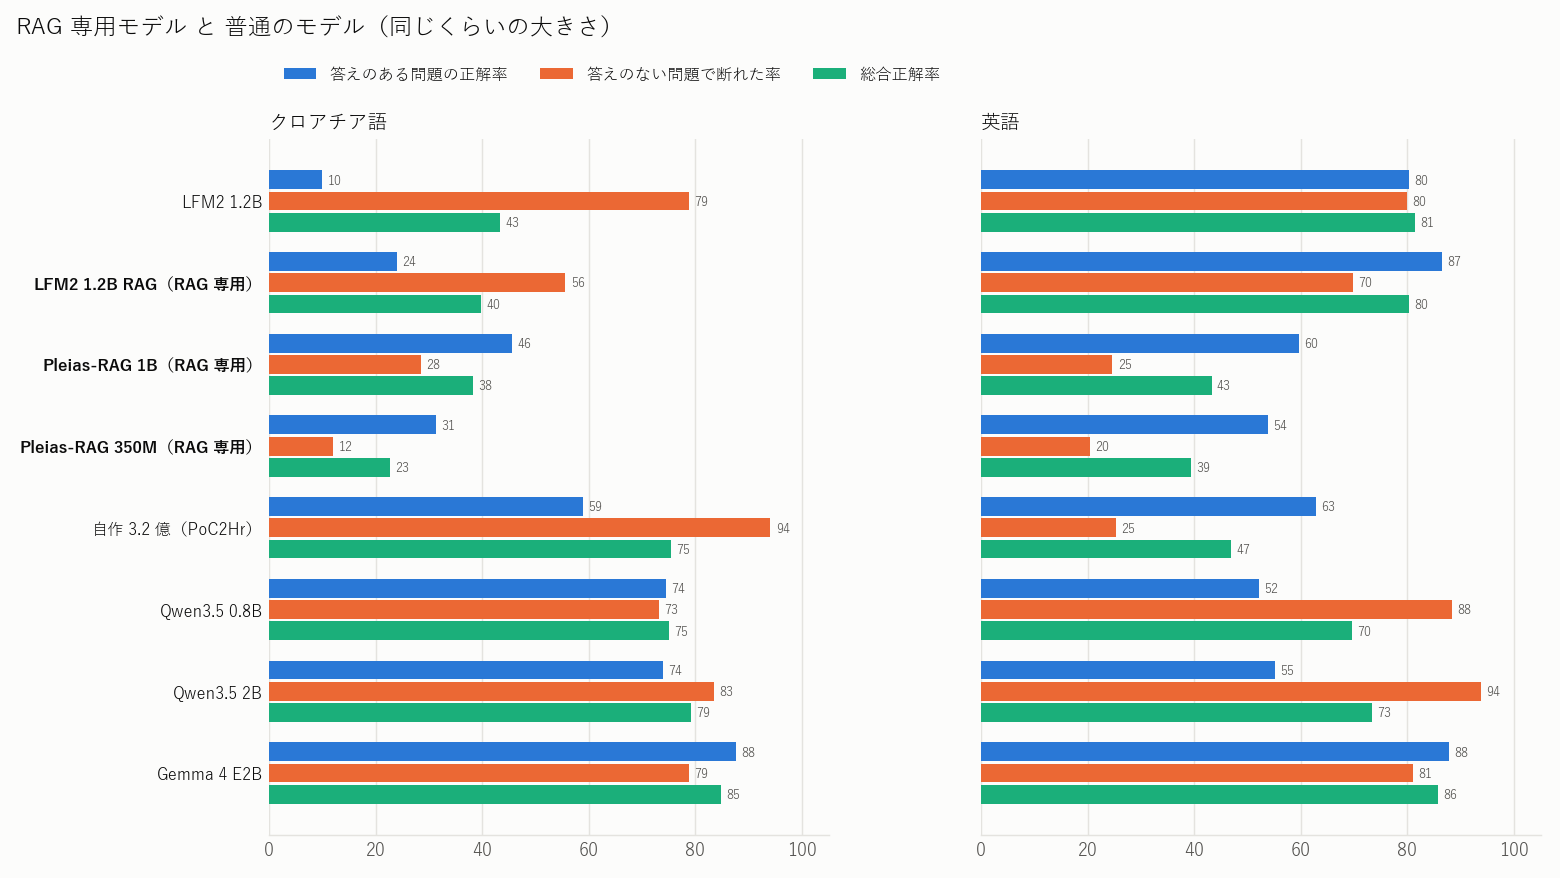
تساءلت: «كيف ستكون النماذج المضبوطة خصيصًا لـ RAG؟»، لذا أضفت ثلاثة نماذج RAG صغيرة وجربتها. الشروط مماثلة لما سبق (المشكلات نفسها وعددها 260، والتقييم نفسه).
- LFM2-1.2B-RAG (Liquid AI): نموذج LFM2-1.2B خضع لتدريب إضافي على أكثر من مليون مثال للإجابة بعد تقديم الوثائق. اللغات المدعومة هي 9 لغات، منها الإنجليزية واليابانية، ولا تشمل الكرواتية
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): نماذج دُرِّبت على نحو 3.1 مليون عنصر من بيانات RAG الاصطناعية. قبل الإجابة، تكتب «تحليل السؤال → تحليل المواد → مسودة»، ثم تضيف إلى الإجابة اقتباسات من النص. تدعم 7 لغات أوروبية، ولا تشمل الكرواتية. والسياق الذي يمكنها التعامل معه يصل إلى 4,096 رمزًا
- للمقارنة، قست أيضًا LFM2-1.2B الأساسي الذي بُني عليه LFM2-1.2B-RAG
قدّمت إلى LFM2-1.2B-RAG التعليمات نفسها التي قُدمت إلى النماذج الأخرى. أما Pleias فلا يقبل إلا تنسيق الإدخال الخاص به (يفصل السؤال والمواد برموز خاصة)، لذلك مررته بالتنسيق نفسه المستخدم في المكتبة الرسمية، وقيّمت جزء الإجابة النهائية فقط. لذلك لم أتمكن من إعطاء Pleias تعليمات «إذا لم توجد إجابة، فأجب هكذا».
| النموذج | الإجمالي (الكرواتية) | الإجمالي (الإنجليزية) | الاختلاق في نص طويل بلا إجابة (الكرواتية / الإنجليزية) | وقت سؤال نص طويل واحد (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (النموذج الأصلي) | 43% | 81% | 42% / 36% | 7.8 ثانية |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8.1 ثانية |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16.9 ثانية |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6.0 ثوانٍ |
| مرجع: نموذجي الخاص 320 مليون | 75% | 47% | 9% / 91% | 2.1 ثانية |
| مرجع: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5.1 ثانية |
| مرجع: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11.1 ثانية |
باختصار، لم أجد في هذه المشكلات أي جانب تتفوق فيه النماذج المخصصة لـ RAG على النماذج العادية.
LFM2-1.2B-RAG: أصبح يجيب أكثر، لكنه أصبح يختلق أكثر أيضًا
بالمقارنة مع LFM2-1.2B الأساسي في الإنجليزية، ارتفع معدل الدقة في المشكلات التي لها إجابة (الفقرات 83% → 87%، والنصوص الطويلة 78% → 86%). لكن الاختلاق في النصوص التي لا إجابة لها ازداد أيضًا (الفقرات 4% → 10%، والنصوص الطويلة 36% → 51%)، وبقي الإجمالي متقاربًا جدًا: 81% → 80%. يبدو أن التدريب الإضافي لـ RAG دفعه نحو نهج «أجب بأي حال».
بالكرواتية، لا يكاد النموذج الأساسي قابلًا للاستخدام من البداية. امتنع LFM2-1.2B الأساسي في 93% من الفقرات التي تحتوي على إجابة بالقول «لا توجد إجابة»، وكانت الإجابات من إصدار RAG كثيرًا ما تعيد نص التعليمات كما هو، مثل «Odgovori kratko, jednom rečenicom.(أجب بإيجاز في جملة واحدة.)». وبما أن الكرواتية ليست ضمن اللغات المدعومة، فهذا متوقع.
Pleias-RAG: يضيف اقتباسات، لكن الاقتباسات ليست موجودة في النص
نادراً ما امتنع Pleias حتى في النصوص التي لا تحتوي على إجابة. ففي الإنجليزية، اختلق إجابات في 78% من الفقرات بلا إجابة و73% من النصوص الطويلة بلا إجابة (1B).
وحتى ميزة «الإجابة المصحوبة باقتباس» التي يروّج لها مشكوك فيها. أحصيت نسبة الحالات التي يمكن فيها العثور على جملة الاقتباس كما هي في النص (إنها مطابقة تامة مع تجاهل اختلافات المسافات فقط، لذلك تُحتسب الاقتباسات التي أُعيدت صياغتها قليلًا ضمن «غير موجودة»).
| المشكلات التي لها إجابة | المشكلات التي لا إجابة لها | |
|---|---|---|
| Pleias-RAG 1B (الإنجليزية) | 64% | 42% |
| Pleias-RAG 1B (الكرواتية) | 57% | 53% |
| Pleias-RAG 350M (الإنجليزية) | 66% | 39% |
| Pleias-RAG 350M (الكرواتية) | 52% | 40% |
على سبيل المثال: «ما الفرقة التي كتبت أغنية Tourniquet أولًا؟» (الإجابة هي Soul Embraced).
- عند تقديم فقرة لا تحتوي على الإجابة، أجاب 1B: «كتبتها Amy Lee»، وأضاف بوصفه اقتباسًا جملة غير موجودة في النص هي: «Amy Lee (born Amy Leigh Lee, November 1, 1970) ...»
- حتى عند تقديم فقرة تحتوي على الإجابة، أجاب: «كتبتها Amy Lee». وكان الاقتباس المضاف هو: «originally written ... for the Christian death metal band Soul Embraced»، أي إن الاقتباس صحيح لكن الإجابة تتعارض معه
وجود اقتباس قد يجعل الإجابة تبدو «مبنية فعلًا على النص»، ولذلك قد يكون الأمر أخطر.
ومن ناحية السرعة أيضًا، يكتب Pleias تحليلاً قبل الإجابة، لذا تكون إجاباته طويلة (بمتوسط 381–420 رمزًا في النصوص الطويلة). استغرق 1B 16.9 ثانية للسؤال الواحد ذي النص الطويل، وهو أبطأ من Gemma 4 E2B (11.1 ثانية). إضافة إلى ذلك، لم تتسع 25% من النصوص الطويلة الكرواتية ضمن السياق (واحتُسبت كإجابات خاطئة؛ والوقت متوسط للحالات التي دخلت فقط، لذا فالوقت الحقيقي أطول قليلًا).
لماذا حدث ذلك؟ (تخمين)
- اللغة: لا تشمل اللغات المدعومة في النماذج الثلاثة الكرواتية. لكنها تخسر أمام النماذج العادية حتى في الإنجليزية
- شكل المشكلات: المشكلات هذه المرة هي «الإجابة باختصار من نص واحد / الامتناع إن لم توجد إجابة». يجري تقييم Pleias في مشكلات تتطلب جمع عدة مصادر للإجابة (مثل HotpotQA)، وربما يختلف الشكل الذي يجيده
- طريقة الامتناع: يمكن إعطاء النماذج العادية تعليمات «إذا لم توجد إجابة، فأجب هكذا»، لكن لا يوجد موضع لتمرير هذه التعليمات إلى Pleias. لدى النموذج نفسه آلية للحكم بأن «لا يمكن الإجابة من هذه المواد»، لكنها لم تعمل جيدًا هذه المرة
خلاصة الإضافة
- من الأفضل ألا تختار اعتمادًا على اسم «مخصص لـ RAG» وحده. في هذه الظروف، كانت نماذج التعليمات العادية مثل Gemma 4 E2B وQwen3.5 أدق، وامتنعت عندما ينبغي لها ذلك
- الإجابة المصحوبة باقتباس لا معنى لها ما لم تتحقق من الاقتباس نفسه. لم يكن من الممكن العثور على اقتباسات Pleias كما هي في النص إلا في 40–70% من الحالات
- نموذجي الخاص أفضل من نماذج RAG المخصصة ذات الحجم المشابه. بالمقارنة مع Pleias-RAG 350M، بلغ الإجمالي بالكرواتية 75% مقابل 23%، وبلغ وقت السؤال الواحد ذي النص الطويل 2.1 ثانية مقابل 6.0 ثوانٍ. كان من المفيد إذًا بناؤه خصيصًا للكرواتية
قست سرعة النماذج الأربعة المضافة في ليلة اليوم نفسه، وعلى الحاسوب نفسه وتحت الشروط نفسها. وأضفتها أيضًا إلى مخطط السرعة والدقة.
جميع النتائج
الكرواتية
| النموذج | الفئة | إجابات صحيحة: الفقرات | إجابات صحيحة: النصوص الطويلة | الإجمالي | اختلاق إجابة عند عدم وجود جواب (فقرات/نصوص طويلة) | نسبة الإجابات الصحيحة من بين الإجابات المقدمة |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | فئة 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | فئة 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | فئة 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | فئة 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | فئة 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | فئة 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | فئة 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | فئة 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | فئة 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | فئة 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | فئة 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | فئة 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| مُخصّص 320 مليون | مُخصّص | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | فئة 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | فئة 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | فئة 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | فئة 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | فئة 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | فئة 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | فئة 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | فئة 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | فئة 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | فئة 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | فئة 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | فئة 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | فئة 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | فئة 1B・مخصص لـRAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | فئة 1B・مخصص لـRAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | فئة 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | فئة 1B・مخصص لـRAG | 54% | 9% | 23% | 85% / 68% | 21% |
الإنجليزية
| النموذج | الفئة | إجابات صحيحة: الفقرات | إجابات صحيحة: النصوص الطويلة | الإجمالي | اختلاق إجابة عند عدم وجود جواب (فقرات/نصوص طويلة) | نسبة الإجابات الصحيحة من بين الإجابات المقدمة |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | فئة 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | فئة 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | فئة 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | فئة 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | فئة 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | فئة 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | فئة 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | فئة 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | فئة 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | فئة 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | فئة 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | فئة 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | فئة 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | فئة 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | فئة 1B・مخصص لـRAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | فئة 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | فئة 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | فئة 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | فئة 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | فئة 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | فئة 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | فئة 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | فئة 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | فئة 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | فئة 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | فئة 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | فئة 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| مُخصّص 320 مليون | مُخصّص | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | فئة 1B・مخصص لـRAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | فئة 1B・مخصص لـRAG | 63% | 44% | 39% | 67% / 92% | 34% |
السرعة على وحدة المعالجة المركزية (i7-13700K・llama.cpp Q4_K_M)
| النموذج | الحجم | التوليد (رموز/ثانية) | القراءة (رموز/ثانية) | عدد رموز الإدخال للنصوص الطويلة | زمن سؤال واحد عن نص طويل |
|---|---|---|---|---|---|
| مُخصّص 320 مليون | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 ثانية |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 ثانية |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 ثانية |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 ثانية |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 ثانية |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 ثانية |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 ثانية |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 ثانية |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 ثانية |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 ثانية |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 ثانية |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 ثانية |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 ثانية |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 ثانية |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 ثانية |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 ثانية |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 ثانية |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 ثانية |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 ثانية |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 ثانية |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 ثانية |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 ثانية |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 ثانية |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 ثانية |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 ثانية |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 ثانية |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 ثانية |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 ثانية |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 ثانية |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 ثانية |
※ يُحتسب متوسط Apertus 1.5B وPleias-RAG للنصوص الطويلة التي تقع بالكامل ضمن سياق من 4,096 رمزًا فقط.