بنيت GPT-2 من الصفر باستخدام RTX 4090 واحد: تفوّق على النسخة الأصلية خلال يوم، وأصبح قادراً على الدردشة
درّبت GPT-2 (124M) من الصفر باستخدام بطاقة RTX 4090 واحدة في منزلي. أنجزت كل شيء على حاسوبي الشخصي، من تجهيز البيانات والتدريب المسبق إلى ضبط التعليمات (SFT) الذي يجعله قادراً على الدردشة.
الخلاصة أولاً:
- اكتمل التدريب المسبق في نحو 21 ساعة. وحقق 30.5% في اختبار الاستدلال المنطقي HellaSwag، متجاوزاً نسبة GPT-2 124M الأصلية البالغة 29.4%
- استغرق SFT أقل من ساعتين. وبعد 5 دقائق فقط من بدء التدريب بدأ يقدّم ردوداً تشبه المحادثة
- لكن مضمونه كان مليئاً بالهلوسات؛ يقول بثقة أشياء مثل: «عدد سكان باريس 2.4 مليار» و«12+7=30»
كان من الممتع مشاهدة GPT-2 وهو يصبح أذكى تدريجياً، لذا لخصت تلك الرحلة هنا.
البيئة
- GPU: RTX 4090 (24GB)
- CPU: i7-13700K / ذاكرة 64GB
- نظام التشغيل: Windows 11 (من دون WSL، مباشرة على Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
اتبعت أسلوب Karpathy نفسه في nanoGPT / build-nanogpt. طلبت من Claude Code أن «يبني GPT-2 ضمن ما يمكن إنجازه على GPU هذا الحاسوب خلال يوم»، وساعدني في كل شيء بدءاً من اقتراح البنية وكتابة السكربتات وحتى مراقبة التدريب.
تجهيز البيانات: 10B رموز جاهزة خلال 12 دقيقة
بيانات التدريب هي نسخة 10B رمز من FineWeb-Edu (نصوص ويب إنجليزية تعليمية عالية الجودة). حجمها نحو 27GB بصيغة parquet.
في البداية لم تتجاوز سرعة التنزيل العادية من Hugging Face 1.7MB/s، ما يعني أن تنزيل كل شيء سيستغرق أكثر من 4 ساعات. بعد تثبيت hf_transfer أصبحت السرعة 60–70MB/s، وصار ملف حجمه 2GB يُنزّل في 30 ثانية. انتقلت عنق الزجاجة إلى مرحلة التقسيم إلى رموز، وأصبحت العملية كلها، التنزيل والتقسيم معاً، تستغرق نحو 12 دقيقة.
وبالمناسبة، وضعت في البداية HF_HOME، الذي يغيّر موقع تخزين الذاكرة المؤقتة، بعد استيراد huggingface_hub، لذلك لم يُطبّق الإعداد ونُزّلت الملفات إلى قرص آخر. تُقرأ قيمة متغير البيئة هذا عند الاستيراد، لذا اضبطه قبل الاستيراد. تفصيلة صغيرة يسهل الوقوع فيها.
إعدادات التدريب
| البند | المحتوى |
|---|---|
| النموذج | GPT-2 small (12 طبقة، 768 بُعداً، 124 مليون مَعلمة) |
| الخطوة الواحدة | نحو 520 ألف رمز (16×1024 مع تجميع تدرج 32 مرة) |
| عدد الخطوات | 16,000 (نحو 8.4B رمز) |
| السرعة | نحو 120 ألف رمز/ثانية |
| VRAM | نحو 12GB |
كثيراً ما تسمع أن torch.compile لا يعمل على Windows وأن عليك استخدام WSL، لكنه عمل مباشرة في بيئة تضم triton-windows.
تجاوز تدريب كامل رموز 10B مدة 24 ساعة، لذلك خفضتها إلى 8.4B رمز كي تنتهي خلال يوم واحد.
كحيلة صغيرة، رفعت حجم المفردات من 50257 إلى 50304 (مضاعف لـ128). إنها تقنية مشهورة من Karpathy تسرّع حسابات المصفوفات على GPU، واتضح أنها مفيدة لاحقاً بطريقة غير متوقعة عند تحويل النموذج إلى دردشة.
حادثة: توقف التدريب بعد ساعتين ونصف
عندما راجعت التقدم، وجدت أن التدريب توقف. السبب كان بيانات التقييم في HellaSwag. تجلب الشيفرات من نمط nanoGPT البيانات من rowanz/hellaswag على GitHub، لكنه أصبح يعرض "451 Unavailable For Legal Reasons" (غير متاح لأسباب قانونية). أدى خطأ 404 إلى إسقاط التدريب بالكامل مع التقييم.
عدّلتها لتقرأ من Rowan/hellaswag على Hugging Face (المحتوى نفسه: 10,042 سؤالاً)، ثم استأنفت من نقطة التحقق التي كانت تُحفظ كل 500 خطوة. وأحطت التقييم بـtry/except كي لا يتوقف التدريب حتى لو فشل التقييم.
في التدريب الطويل، لا تدع فشلاً في عناصر «خارجية» مثل التقييم أو السجلات يُسقط التدريب. هذه نقطة مهمة.
النتيجة: تفوق على GPT-2 الأصلي
كان فقدان بيانات التحقق كما يلي: هبط بقوة في الساعة الأولى، ثم واصل الانخفاض تدريجياً.
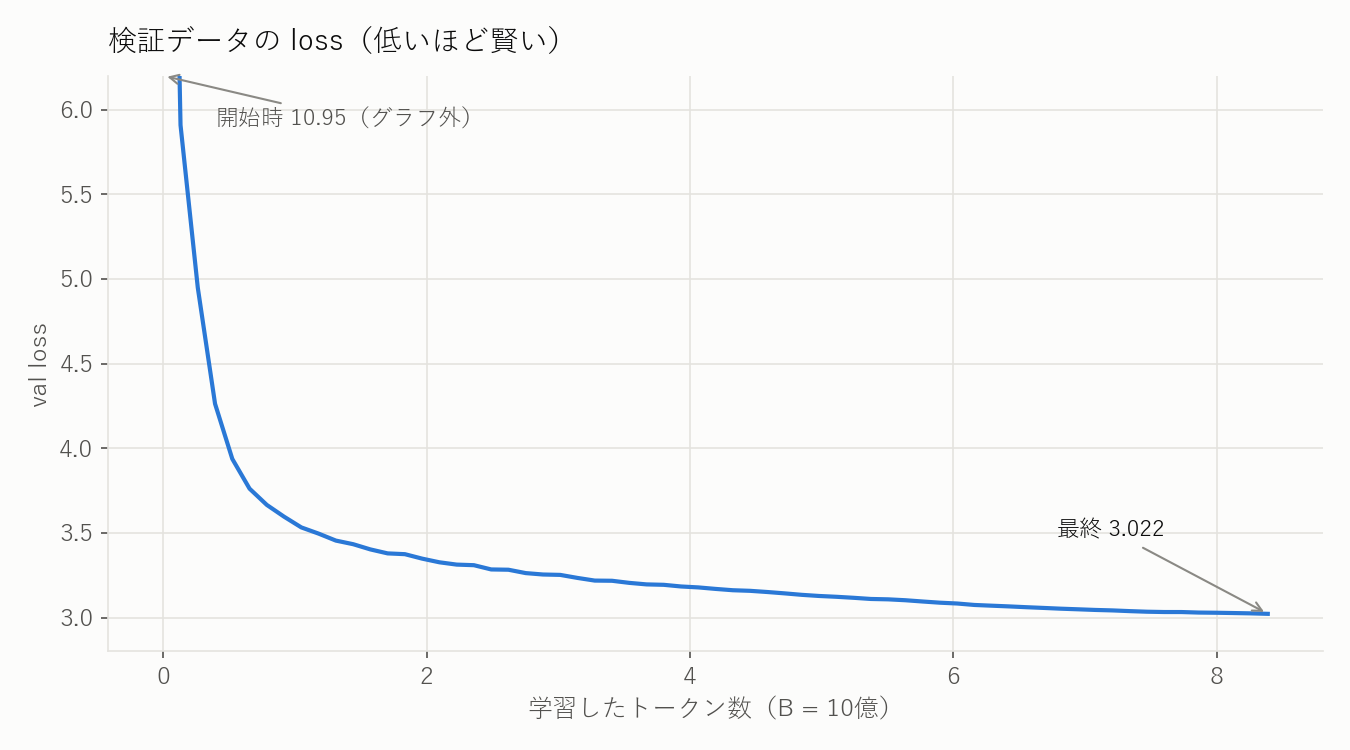
فقدان البداية البالغ 10.95 يكاد يساوي ln(50304)≒10.83. أي إن النموذج بدأ وهو يختار عشوائياً تماماً من بين 50 ألف كلمة.
وكانت دقة HellaSwag كما يلي.
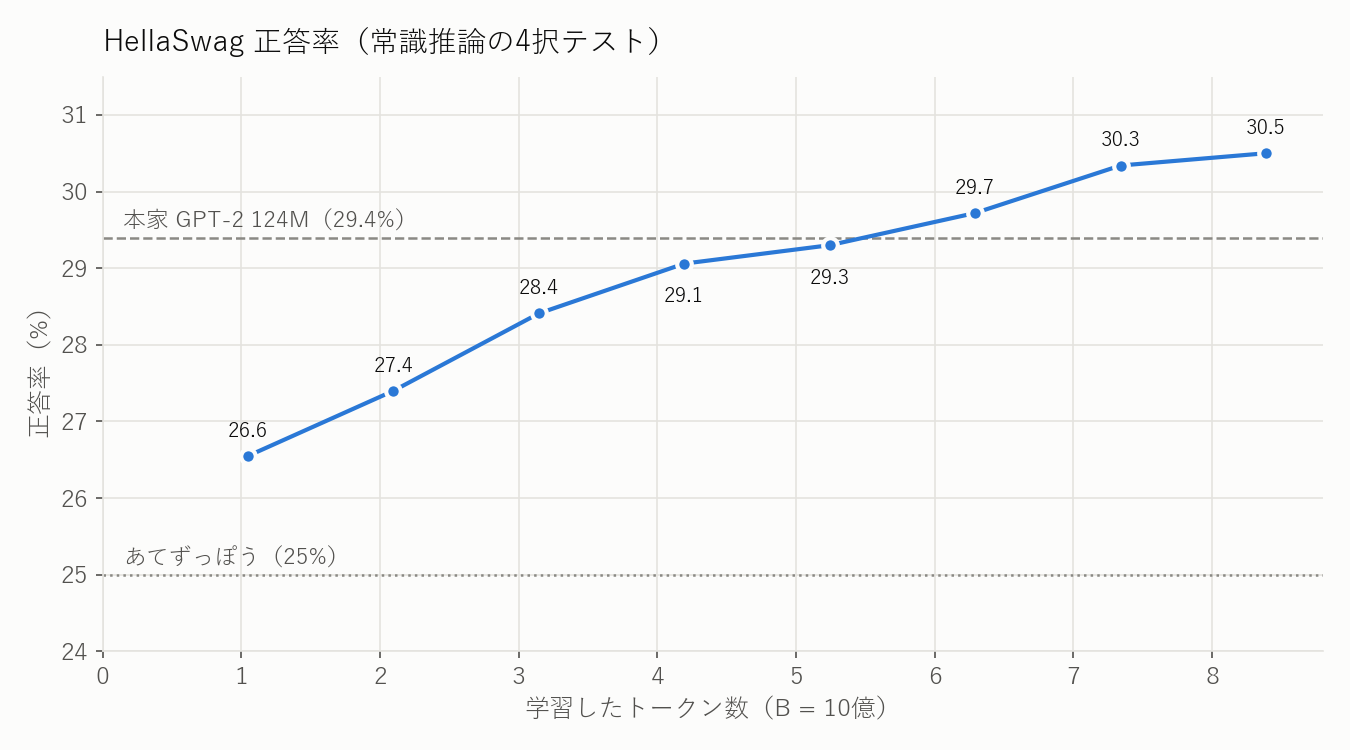
عند نحو 6.3B رمز (الخطوة 12,000) تجاوز نسبة GPT-2 124M الأصلية البالغة 29.4%، وانتهى عند 30.5%. دُرّب GPT-2 الأصلي على WebText، بينما استخدمت هنا FineWeb-Edu؛ وأظن أن الاعتماد على بيانات تعليمية عالية الجودة كان له أثر واضح.
كيف أصبح أذكى شيئاً فشيئاً
أثناء التدريب، كنت أُولّد نصاً بالمطالبة نفسها كل ساعة وأسجل النتيجة. كان ذلك الجزء الأكثر متعة.
قبل التدريب (حالة عشوائية)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
مجرد كلمات مرتبة عشوائياً تماماً.
بعد 37 دقيقة (0.26B رمز)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
أصبح النص في هيئة جملة. يفهم أنه يتحدث عن «عاصمة»، لكنه يقول إن عاصمة فرنسا هي عاصمة اسكتلندا.
بعد نحو ساعتين (0.79B رمز)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
أصبحت القواعد طبيعية إلى حد كبير. لكن في المقابل بدأ يصفّ المصطلحات المتخصصة ليؤلف كذبة تبدو معقولة. كأنها النموذج الأولي للهلوسة.
عند نحو 2.1B رمز
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
وأخيراً قال Paris!… لكنه أضاف بعدها مباشرة إحصائية كاذبة مفادها أن «فرنسا تنتج 50% من فولاذ العالم».
جرّبت سؤال النموذج الأساسي المكتمل
طرحت عليه 10 أسئلة بصيغة Question: ... Answer:.
- What is the capital of France? → يسرد خيارات من (a) إلى (i) ويبدأ في إعداد ورقة أسئلة
- Who was Albert Einstein? → «وُلد في 16 نوفمبر 1918 في سانت لويس بولاية ميزوري. كان والده عامل منجم، وكان هو معلماً في المدرسة». كل ذلك كذب، لكنه قادر على صياغته بأسلوب سيرة ذاتية
- What is 12 plus 7? → «12 plus 7 is an arithmetic expression.». بدل أن يحسب، يبدأ بشرح التعريف
لديه قدر لا بأس به من المعرفة، لكنه لا يعرف سلوك «الإجابة عن سؤال». النموذج الأساسي آلة لكتابة تكملة النص لا أكثر، لذا فهذا طبيعي.
جعلته قادراً على الدردشة باستخدام SFT
بعد ذلك أجريت ضبط التعليمات (SFT) كي يتمكن من الإجابة عن الأسئلة مثل ChatGPT.
- البيانات:
smol-smoltalkمن Hugging Face (نحو 460 ألف محادثة، 270 مليون رمز) - صيغة الدردشة: أضفت علامات فصل مثل
<|user|>و<|assistant|>و<|end|>. وهنا أعدت استخدام الأرقام الفارغة التي ظهرت عند رفع حجم المفردات إلى 50304. أمكن إضافة رموز خاصة من دون تغيير بنية النموذج، فكانت الحيلة الصغيرة المخصصة للسرعة مفيدة هنا - يُدرَّب على جزء الإجابة فقط: يقرأ السؤال فقط، أما ما يُطلب منه محاكاته فهو إجابة المساعد ورمز
<|end|>الأخير - حقبتان تدريبيتان، نحو ساعة و50 دقيقة
النقطة المهمة هي تدريبه حتى <|end|>. بذلك يتعلم النموذج أن يتوقف بنفسه عند انتهاء كلامه. تستخدم ChatGPT وما شابهها الآلية ذاتها: يتوقف التوليد عند إخراج رمز النهاية.
أصبح شبيهاً بالمحادثة خلال 5 دقائق فقط
قبل بدء SFT (الخطوة 0)، أربكته علامات الفصل غير المألوفة وظل يكرر «jakjakjakjak…» بلا نهاية. لكن عند 500 خطوة (نحو 5 دقائق) أصبح شبيهاً بالمحادثة بالفعل.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
بل إنه ينهي كلامه ويتوقف بشكل صحيح. تعلّم أسلوب الحديث كان فورياً تقريباً.
لكن المعرفة بقيت كما هي. قال أحد النماذج الوسيطة إن «باريس أكبر مدينة في العالم، ويبلغ عدد سكانها نحو 2.4 مليار نسمة».
مقارنة قبل SFT وبعده
قارنت الإجابات عن الأسئلة نفسها قبل SFT (النموذج الأساسي) وبعده.
| السؤال | قبل SFT | بعد SFT |
|---|---|---|
| What is the capital of France? | يبدأ بسرد الخيارات (a) إلى (i) | «The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.» |
| Who are you? | «I am the person who has the gift for all that I do.» | «I'm a language learning AI assistant with over 10 years of experience» (ذكاء اصطناعي لديه 10 سنوات من الخبرة!) |
| Translate "Good morning" into French. | يبدأ حديثاً لا علاقة له بالسؤال | «Bonjour!» (صحيح، لكنه يواصل بعدها تكرار «Good morning (modifier)» بلا توقف) |
| What is 12 plus 7? | يقول إنها «arithmetic expression» | «12 + 7 = 21» → «12 + 7 = 30» → «35 + 7 = 34»؛ يخطئ مراراً وتكراراً بأسلوب حل يبدو مقنعاً |
| Who was Albert Einstein? | معلّم مدرسة ووالده عامل منجم | الإطار العام صحيح: «prominent physicist». لكن «وُلد في 24 فبراير 1905 في فيينا» كذب |
أسلوبه وصيغته صارا تماماً كالمساعد، لكن مضمونه مليء بالأكاذيب. وكان سيئاً للغاية في الحساب.
جرّبت الدردشة فعلياً
أنشأت chat.py يتيح المحادثة في الطرفية، ثم تحدثت إليه.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
إنه يلتزم بتعليمات «في جملة واحدة». وهذا ما لم يكن النموذج الأساسي قادراً عليه.
وفي محادثة أخرى، سألت عن العاصمة ثم تابعت بالسؤال عن عدد السكان.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
فهم من المحادثة السابقة أن there تعني اليابان. لكنه قال إن عدد سكانها 50 ألفاً ثم زعم مباشرة أن 1.5 مليار شخص يعيشون في شمالها؛ فوضى عارمة.
وعندما سألته باليابانية «ما عاصمة اليابان؟»، أجاب هكذا:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
بما أنه لم يتعلم سوى بيانات إنجليزية، بدا أن اليابانية بالنسبة إليه «نص غامض يحتاج إلى تدقيق».
وأخيراً طلبت منه «اكتب هايكو عن GPU»، فكانت النتيجة قصيدة تكرر فيها عبارة «I see the world, the thoughts, the emotions» بلا توقف. أي هايكو هذا؟
ما تعلمته من التجربة
- باستخدام 4090 واحدة ويوم واحد، يمكنك صنع نموذج يتفوق على GPT-2 الأصلي. استهلاك GPU للطاقة نحو 430W، وتكلفة الكهرباء للـGPU وحده تقارب 300 ين تقريباً (تقدير)
- يتعلم أسلوب الكلام في لحظة، لكن المعرفة تُحسم في التدريب المسبق. أصبح في هيئة محادثة خلال 5 دقائق من SFT، لكن دقة الحقائق لم تتغير تقريباً
- نموذج بحجم 124M قواعده تكاد تكون مثالية، لكن مضمونه مليء بالأكاذيب. يتضح لك بصورة ملموسة أن الطلاقة والصحة أمران مختلفان
- التدريب الطويل يتعثر بسبب البنية التحتية. توقف التدريب هذه المرة لا بسبب النموذج، بل لأن مكان استضافة بيانات التقييم اختفى
عندما تبني النموذج بنفسك من الصفر، تدرك عملياً أن الذكاء الاصطناعي مثل ChatGPT هو «آلة تتنبأ بتكملة النص» جرى تعليمها «آداب المحادثة». في المرة القادمة أود تجربة بناء نموذج أكثر قرباً من الاستخدام العملي.