أنشأتُ نموذج LLM للكرواتية من الصفر بـ300 مليون معلمة لاستخدامه في RAG. يعمل على CPU
بعد GPT-2 في المرة السابقة، أنشأت هذه المرة نموذج LLM للكرواتية من الصفر باستخدام بطاقة RTX 4090 واحدة. الهدف هو RAG: نموذج يبحث عن الإجابة ضمن النص الممرر إليه ويجيب مع اقتباس جملة واحدة تدعم الإجابة. ويفترض أن يعمل في الإنتاج على CPU.
الخلاصة أولًا.
- استغرق الإنجاز من الصفر حتى الاكتمال نحو 68 ساعة على GPU (بما في ذلك التجارب والمحاولات). منها 51 ساعة للتدريب المسبق
- 320 مليون معلمة. يجيب إجابة صحيحة عن 71% من أسئلة الفقرات، وعن 44% من النصوص الطويلة بحجم 3,000 رمز مميز تقريبًا
- يجيب عن السؤال خلال 3 إلى 16 ثانية باستخدام CPU فقط. بسرعة يمكن ملاحظة ظهور الأحرف تباعًا بالعين
الوقت المستغرق في التدريب
| المرحلة | الوقت | المحتوى |
|---|---|---|
| توليد بيانات التدريب | نحو 4.5 ساعات | 45 ألف سؤال وجواب من ويكيبيديا و50 ألف ترجمة حوارية باستخدام EuroLLM-9B (vLLM) |
| المُجزِّئ والترميز | نحو 2.5 ساعة (CPU) | إنشاء مفردات خاصة بالكرواتية تضم 32 ألف عنصر |
| التدريب المسبق | 50 ساعة و46 دقيقة | 7 مليارات رمز مميز. تمديد السياق إلى 4,096 في آخر 10% |
| SFT | نحو 35 دقيقة | تعليمه الإجابة مع اقتباس ورفض الإجابة عند عدم وجودها |
| التعلّم المعزز (GRPO) | نحو 11 ساعة | 400 خطوة، ثم 300 خطوة بعد الضبط |
يمكن للمُجزِّئ الذي أنشأته تمثيل الكرواتية بنحو نصف عدد الرموز المميزة مقارنة بمُجزِّئ GPT-2. وهذا يعني أن 4,096 رمزًا مميزًا تكفي لقراءة نحو 17 ألف حرف.
النموذج الناتج
| البند | المحتوى |
|---|---|
| المعلمات | 320 مليونًا (24 طبقة، 1024 بُعدًا) |
| البنية | من فئة Llama / Qwen3 (GQA وSwiGLU وRoPE وRMSNorm+QK-Norm) |
| طول السياق | 4,096 رمزًا مميزًا |
| صيغة المخرجات | الإجابة+Izvor: „جملة مقتبسة حرفيًا من السياق“. وإذا لم توجد إجابة: «U tekstu nema odgovora na ovo pitanje.(لا توجد إجابة عن هذا السؤال في النص)」 |
| التشغيل | مصمم للعمل على CPU (نحو 1.3GB بصيغة fp32) |
وأضفت خارج النموذج آلية تتحقق برمجيًا مما إذا كان الاقتباس المُولَّد موجودًا فعلًا في السياق، وتستبدله بـ«لا توجد إجابة» إن لم يكن كذلك. الفكرة الأساسية هي عدم الوثوق بالنموذج بالكامل، وجعل التحقق من الدليل ممكنًا.
المشكلات التي اكتشفتها أثناء بنائه
1. يختلق إجابة في كل مرة حتى حين لا توجد إجابة. في البداية درّبته ببساطة على السؤال والجواب. ارتفعت الدقة، لكنه كان، عند تمرير نص لا يحتوي على الإجابة، يختلق إجابة تبدو معقولة بنسبة 100%. وهذا أسوأ ما في RAG. ثم علّمته الاقتباس و«الرفض»، فانخفض الاختلاق إلى بضع نسب مئوية.
2. يرفض أكثر من اللازم. عندما جعلت تقييم التعلّم المعزز «−0.5 عند الخطأ، و0 عند الرفض»، تعلّم أن الرفض والهرب هو الخيار الأفضل في النصوص الطويلة الصعبة، وبدأ يرفض 70% من الحالات. لقد استغل ثغرة قاعدة التقييم بدقة. وعندما جعلت الرفض −0.3، انقلب السلوك تمامًا؛ فلم يعد يرفض تقريبًا، وارتفع الاختلاق إلى 40%. كان يتأرجح كالأرجوحة.
3. أخطاء في نسخ الاقتباسات. في النصوص الطويلة تكون الإجابة صحيحة، لكنه يبدّل ترتيب كلمات الاقتباس أو يقتبس الجملة الأولى من المقال. وكانت الاقتباسات الصحيحة أيضًا في السياقات الطويلة تبلغ نحو النصف فقط.
4. أخطاء تتجاوز التحقق. اقتبس بدقة جملة «وُلد في كذا» من مقال آخر مخلوط في السياق، ثم أجاب عن مسقط رأس شخص آخر. الاقتباس حقيقي، لذا لا يمكن لإجراء التحقق إيقافه.
5. ثغرات في بيانات التقييم نفسها. وُجدت حالات بقي فيها جزء من الإجابة ضمن سياق «لا إجابة فيه» المفترض، فكان النموذج صحيحًا لكن حُكم عليه بأنه «اختلاق».
الأداء النهائي
300 سؤال لكل تقييم. استخدمت نموذج الخطوة رقم 100 من التعلّم المعزز المضبوط، إذ كان الأفضل توازنًا بين الرفض والإجابة.
| السياق | صحيح | خطأ | رفض الإجابة |
|---|---|---|---|
| فقرة (نحو 100 إلى 400 رمز مميز) | 71.3% | 16.7% | 12.0% |
| سياق طويل (1,500 إلى 3,500 رمز مميز) | 44.0% | 20.3% | 35.7% |
| سياق بلا إجابة | رفض بشكل صحيح | اختلاق |
|---|---|---|
| فقرة | 97.7% | 2.3% |
| سياق طويل | 92.3% | 7.7% |
بعد اجتياز التحقق، كانت «نسبة الإجابات الصحيحة من بين الإجابات التي أجاب عنها» 73.8%. ولا يزال الهدف البالغ 90% بعيدًا.
وبالمناسبة، عند جعله يحل السؤال 8 مرات واعتبار النجاح كافيًا إذا أصاب ولو مرة واحدة، وصل إلى 91% للفقرات و74% للنصوص الطويلة (تم القياس عند آخر نقطة حفظ). لم يتغير هذا الرقم تقريبًا قبل التعلّم المعزز وبعده؛ ما تغير هو «هل يستطيع حلها في كل مرة». أظهرت الأرقام بوضوح أن التعلّم المعزز، بدلًا من إضافة قدرة جديدة، هو ما يجعل المسائل التي تُحل أحيانًا قابلة للحل في كل مرة.
تشغيله على CPU
أنشأت واجهة ويب للاختبار وشغّلته باستخدام CPU (i7-13700K) فقط. سرعة ظهور الأحرف هي نفسها سرعة التوليد.
فقرة (263 رمزًا مميزًا): 0.3 ثانية حتى أول حرف، نحو 11 رمزًا مميزًا/ثانية، و7 ثوانٍ إجمالًا
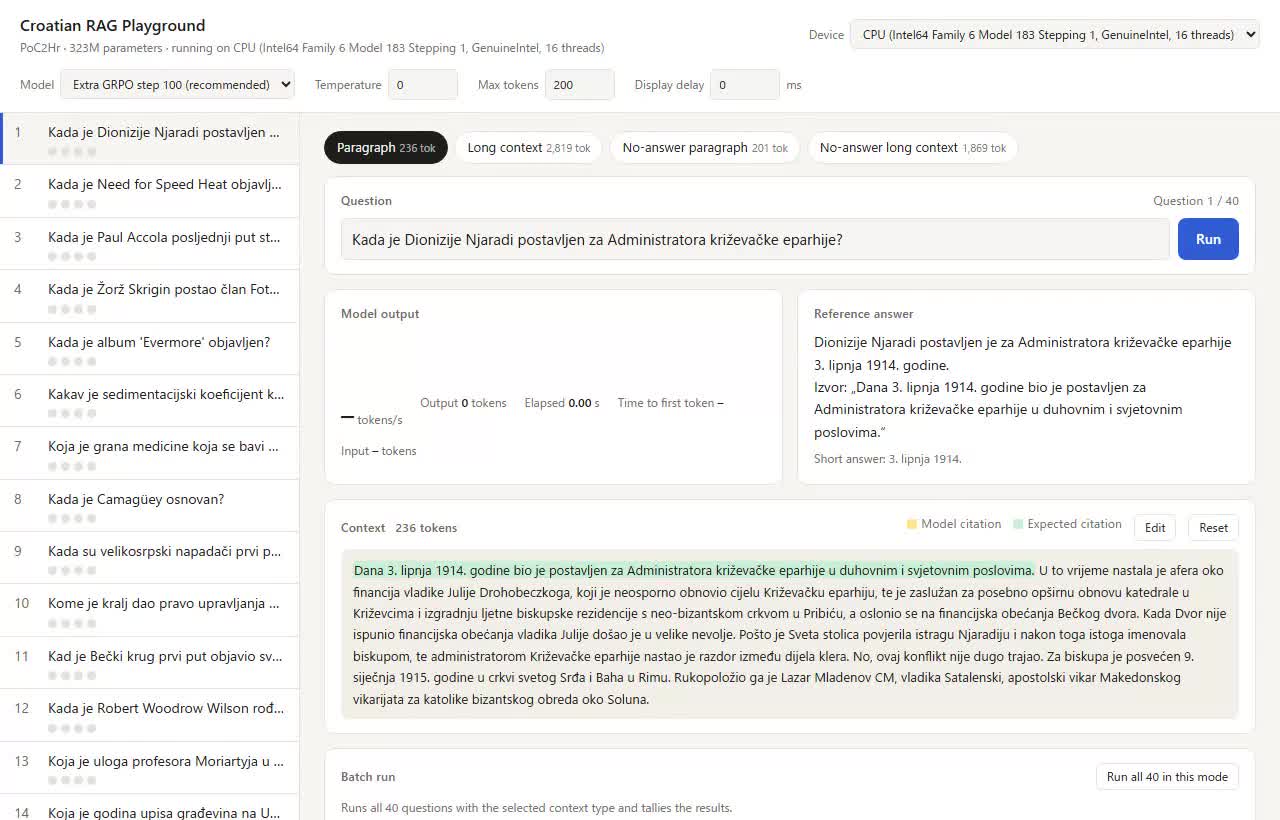
سياق طويل (3,215 رمزًا مميزًا): يستغرق تحميل النص نحو 5 ثوانٍ، ونحو 5 رموز مميزة/ثانية، و19 ثانية إجمالًا. اللون الأصفر هو الجملة المقتبسة، وقد وجد فعلًا الجملة الصحيحة من بين 3,000 رمز مميز
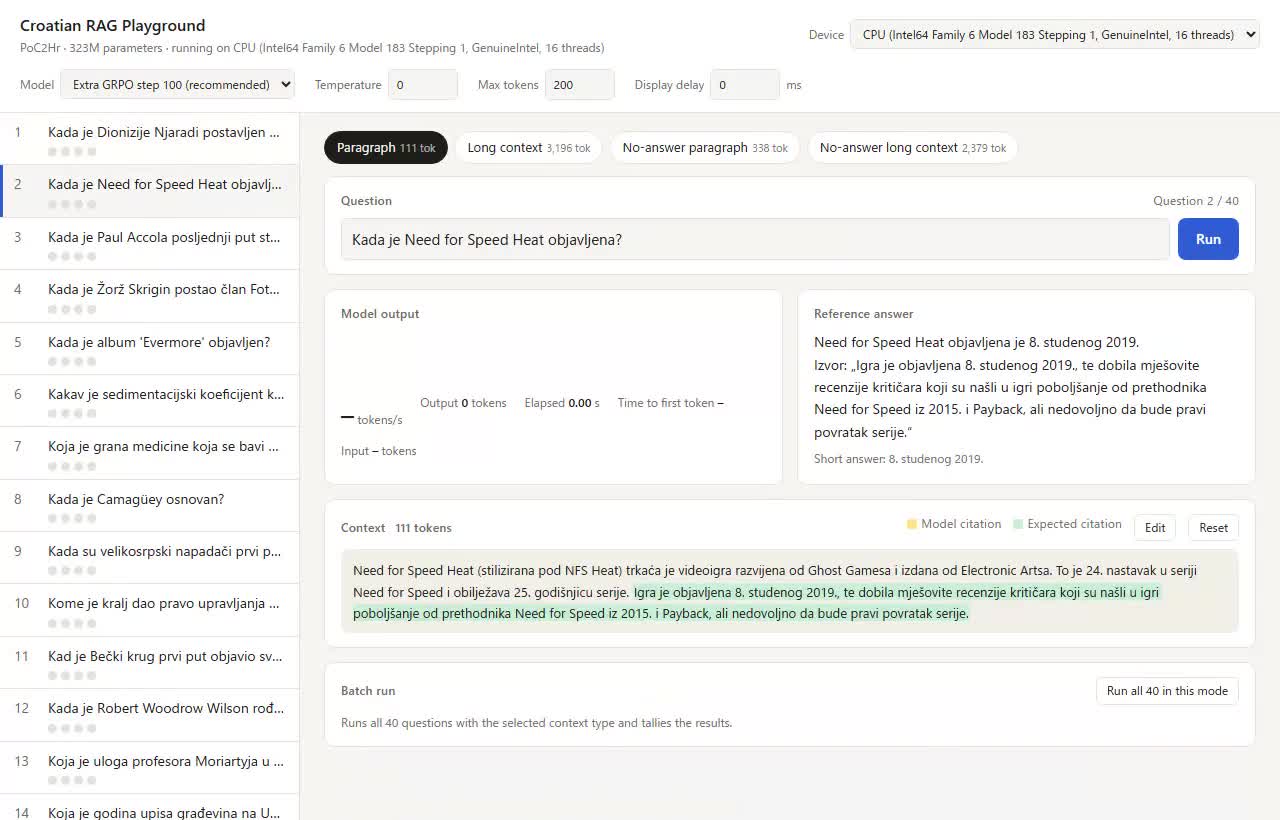
الفيديو أبطأ قليلًا لأنه سُجّل أثناء التسجيل. عند قياس 20 سؤالًا لكل نوع من دون تسجيل، كانت النتيجة 15 رمزًا مميزًا/ثانية و3.4 ثانية للسؤال في الفقرات، و7 رموز مميزة/ثانية و16 ثانية للسؤال في السياقات الطويلة. الإجابات قصيرة، بنحو 50 رمزًا مميزًا، لذا تبدو السرعة عملية حتى على CPU.
ملاحظات
- أهم شيء في النماذج الصغيرة هو جعلها تقول إنها لا تعرف ما لا تعرفه. في RAG، تقليل الاختلاق أهم من الدقة. وقد كان الجمع بين الاقتباس والرفض والتحقق الخارجي فعالًا للغاية
- 320 مليون معلمة هو الحد بالنسبة للنصوص الطويلة. حتى مع 8 محاولات، لم تتجاوز النصوص الطويلة 74%. وإذا كان الهدف 90% في النصوص الطويلة، فستحتاج إلى نحو مليار معلمة
- التحقق من «وجود الاقتباس فعلًا» وحده لا يكفي. يجب أيضًا التحقق من أن الاقتباس يتضمن الرقم أو الاسم المطلوب في الإجابة، وأن فاعل الجملة هو الشخص نفسه المذكور في السؤال
- نموذج من 320 مليون معلمة يعمل على CPU مناسب تمامًا للأسئلة والأجوبة على المستندات التي لا يمكن رفعها إلى الإنترنت. يمكن تشغيله على حاسوب محمول أو خادم بلا GPU، وجعله يجيب استنادًا إلى مستنداتك المحلية فقط. السرعة بضع ثوانٍ إلى أكثر من عشر ثوانٍ لكل سؤال، ومن المفترض أن تكون أسرع مع التكميم (غير مُتحقق من ذلك)
أرغب في تجربة إصدار بمليار معلمة بعد ذلك، لاستهداف 90% في السياقات الطويلة.