أنشأتُ نموذجًا لتحويل النص إلى كلام بالكرواتية بـ32 مليون معلَمة: مقارنة الأصوات أثناء التدريب
نموذج TTS كرواتي صغير يعمل لحظيًا على المعالج، مع مقارنة جودة الصوت عبر مراحل التدريب.
بعد نموذج لغوي كبير للـRAG باللغة الكرواتية، جرّبت هذه المرة إنشاء نموذج صغير مخصّص لتحويل النص إلى كلام (TTS) بالكرواتية. كان الهدف أن يعمل لحظيًا على معالج الهاتف الذكي.
الطريقة هي «التقطير». جعلتُ نموذجًا كبيرًا لتحويل النص إلى كلام (HiggsAudio v3) يقرأ نصوصًا كرواتية لإنشاء بيانات التدريب، ثم درّبت نموذجًا صغيرًا من الصفر عليها. في هذه المرة، أجريتُ تدريبًا تجريبيًا أوليًا على بيانات مدتها 7.5 ساعات، وقارنتُ كيف تتغير الجملة نفسها مع تقدّم التدريب.
الخلاصة أولًا.
- بـ32 مليون معلَمة (Matcha-TTS بـ18.3 مليون + Vocos بـ13.5 مليون)، نطق النموذج بالكرواتية فعلًا
- عند 50 دقيقة من التدريب (5,000 خطوة)، كان يقرأ بالفعل كما هو مكتوب في النص. التحسن بعد ذلك كان أساسًا في «الضوضاء»
- بلغ معدل خطأ المحارف في 14 جملة تقييمية 0.9% في النهاية (تطابقت 10 من أصل 14 جملة تمامًا)
- حتى بخيط CPU واحد، أمكنه إنتاج ثانية واحدة من الصوت خلال 0.09 ثانية (i7-13700K)
عرض توضيحي: دعونا نجعله يتحدث فعلًا
وضعتُ النسخة النهائية ذات 30,000 خطوة من نموذج هذه المقالة في ساحة تجربة TTS الكرواتية. أدخل أي نص كرواتي، وسيُقرأ لك فورًا.
- يمكنك الاختيار من 50 جملة مثال (تحيات، سفر، مستشفى وغيرها)، أو إدخال نصك الخاص حتى 1,000 حرف
- يمكنك تغيير سرعة الكلام، ومدى التنغيم، وعدد خطوات التوليد. عند تثبيت البذرة، سيُنتج النص نفسه الصوت نفسه في كل مرة
- يعمل التوليد على CPU الخادم فقط (ONNX Runtime؛ لا يستخدم GPU ولا واجهات API خارجية)
- لا يستطيع قراءة الأرقام، لذلك يجب كتابتها كلماتٍ، مثل «dvadeset pet(25)」
ما الذي فعلته
1. إنشاء النصوص: جعلتُ Gemma 4 31B محليًا يكتب حوارات يومية باللغة الكرواتية. حدّدتُ عشوائيًا الموقفَ والمخاطَبَ والعاطفةَ والطولَ، مثل «التحدث مع جدة في السوق» أو «الخوف من صوت غريب في منتصف الليل»، بـ22 سطرًا في كل مرة. الإعداد هو متحدثة واحدة في الثلاثينيات من عمرها. ومزجتُ 23 نوعًا من المشاعر (عادي، فرح، غضب، همس، وغيرها).
2. تحويلها إلى صوت: جعلتُ HiggsAudio v3 يقرأ النصوص بصوت تسجيل مرجعي مدته 16 ثانية. عند إضافة وسوم المشاعر (مثل <|emotion:anger|>)، يغضب أو يفرح كما ينبغي. أنشأتُ 4,500 مقطع في نحو 5 ساعات.
3. فحصها تلقائيًا: نسختُ الصوت باستخدام Whisper large-v3 وقارنته بالنص لاستبعاد أخطاء القراءة. كذلك قستُ، باستخدام نموذج للتعرّف على المتحدث، مدى تقارب الصوت من التسجيل المرجعي، واستبعدتُ المقاطع التي تغيّر فيها الصوت. نجح 4,393 مقطعًا من أصل 4,500 (97.6%). وبعد قص الصمت في البداية والنهاية، أصبحت المدة 7.46 ساعات.
4. تدريب النموذج الصغير: درّبتُ Matcha-TTS (نظام TTS يعتمد مطابقة التدفق) لمدة 5 ساعات على RTX 4090، لنحو 30 ألف خطوة. أما الجزء الذي يعيد الصوت إلى موجة صوتية، أي الـvocoder، فاستخدمتُ فيه Vocos المنشور كما هو.
تُقرأ الكرواتية تقريبًا كما تُكتب، لذلك أدخلتُ الأحرف مباشرةً بدل تحويلها إلى رموز نطقية. لكن lj وnj وdž تمثل أصواتًا منفردة، لذا جُمعت كل منها كحرف واحد.
مقارنة الأصوات في أثناء التدريب
ولّدتُ بالجمل غير الموجودة في بيانات التدريب: «Molim Vas, možete li mi reći koliko košta ova haljina?(عذرًا، كم سعر هذا الفستان؟)」، باستخدام نماذج من مراحل تدريب مختلفة.
الخطوة 5,000 (بعد نحو 50 دقيقة من بدء التدريب)
الخطوة 10,000 (نحو ساعة و40 دقيقة)
الخطوة 15,000 (نحو ساعتين و20 دقيقة)
الخطوة 20,000 (نحو 3 ساعات و10 دقائق)
الخطوة 30,000 (نحو 5 ساعات، النسخة النهائية)
وللمقارنة، هذه عينة واحدة من بيانات التدريب التي أنشأها HiggsAudio، بدور المعلّم (جملة أخرى: «Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.»).
عند نسخها بواسطة Whisper، كانت هذه الجملة مطابقة للنص حرفًا بحرف، من الخطوة 5,000 حتى النهاية. أي إن جانب «ماذا يقول» كان متقنًا منذ البداية.
الاختلاف هو نظافة الصوت. بحسب الانطباع السمعي، كانت الخطوة 5,000 تحمل ضوضاء خشنة، وانخفضت بدرجة كبيرة في الخطوة 10,000. ويتضح ذلك جيدًا عند تحويل الصوت نفسه إلى مخطط طيفي (المحور الأفقي للزمن والعمودي للتردد).
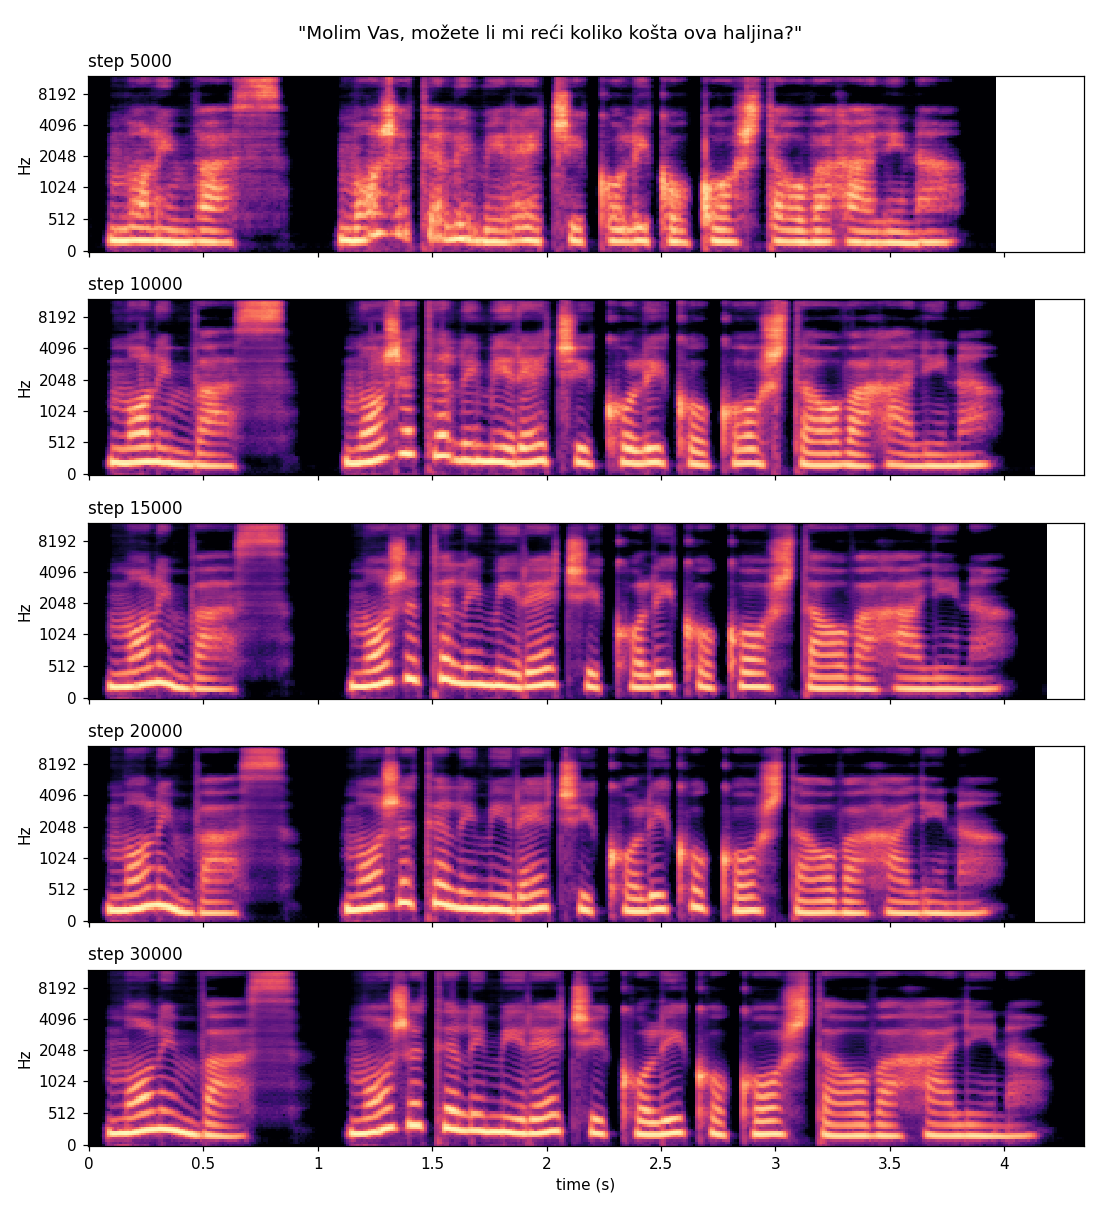
تبدو الخطوط الأفقية المتوازية مع طبقة الصوت (التوافقيات) ضبابية في الخطوة 5,000، وتمتلئ المسافات بينها بعكارة. وهذا هو الجزء الذي يُسمع كضوضاء. منذ الخطوة 10,000 تصبح الخطوط حادة وتصبح المسافات داكنة. ومع تقدّم التدريب، بدأت الخطوط تنحني صعودًا وهبوطًا بسلاسة، ويبدو أن حركة طبقة الصوت (التنغيم) أصبحت أوضح أيضًا.
بالأرقام
نسختُ 14 جملة للتقييم، جميعها خارج بيانات التدريب، باستخدام Whisper large-v3، وقستُ معدل خطأ المحارف (CER). تتراوح من تحيات قصيرة إلى مونولوجات تدوم نحو 16 ثانية.
| الخطوات | وقت التدريب | معدل خطأ المحارف | تطابق تام |
|---|---|---|---|
| 5,000 | نحو 50 دقيقة | 1.1% | 9 / 14 |
| 10,000 | نحو ساعة و40 دقيقة | 3.4% | 8 / 14 |
| 15,000 | نحو ساعتين و20 دقيقة | 0.7% | 11 / 14 |
| 20,000 | نحو 3 ساعات و10 دقائق | 0.9% | 11 / 14 |
| 30,000 | نحو 5 ساعات | 0.9% | 10 / 14 |
- ساء الرقم في الخطوة 10,000 لأن Whisper سمع تقريبًا جملة واحدة هي «Bok!(مرحبًا)」على أنها «Vok». فرق حرف واحد من ثلاثة أحرف يجعل معدل الخطأ في هذه الجملة وحدها 33%. لكن عند الاستماع، كانت الخطوة 10,000 أنظف بكثير من الخطوة 5,000. معدل خطأ المحارف يقيس فقط «هل يُقرأ النص؟»، لذا لا بد من الحكم على نظافة الصوت بالاستماع
- الأخطاء التي بقيت حتى النهاية كانت في đ وdž في «Đak je pojeo džem(أكل الطالب المربى)». وهما صوتان نادران نسبيًا حتى في الكرواتية، وقد نُسخت الجملة على أنها «Žak» و«Džak»
السرعة على CPU
قستُ الأداء على i7-13700K باستخدام PyTorch كما هو، من دون تحسين. المتوسط لثلاث عمليات توليد لأربع جمل بإجمالي 47.6 ثانية من الصوت. يشير RTF إلى «زمن الإنتاج ÷ مدة الصوت»، وكلما صغر كان أسرع.
| عدد الخيوط | عدد الخطوات | Matcha | Vocos | إجمالي RTF |
|---|---|---|---|---|
| 1 | 2 | 0.042 | 0.025 | 0.067 |
| 1 | 4 | 0.067 | 0.025 | 0.092 |
| 4 | 4 | 0.032 | 0.010 | 0.042 |
| 8 | 4 | 0.028 | 0.007 | 0.036 |
«عدد الخطوات» هو عدد مرات التكرار لصنع الصوت من الضوضاء عند التوليد، واستخدمتُ 4 خطوات في المقارنة الصوتية أعلاه. حتى بخيط واحد، يمكن إنشاء ثانية من الصوت في 0.09 ثانية. معالج الهاتف أبطأ من ذلك، لكنه يُفترض أن يظل في نطاق الزمن الحقيقي (لم أختبره على جهاز فعلي بعد، لذا فهذا مجرد توقّع).
كم ساعة من البيانات يحتاج TTS؟
بما أن 7.5 ساعات كانت كافية للوصول إلى هذه النتيجة، بحثتُ عن الإرشادات العامة.
- مجموعة LJSpeech الإنجليزية، الشائعة لنماذج TTS بصوت متحدث واحد، تضم نحو 24 ساعة. ونموذج Matcha-TTS الرسمي مدرّب عليها أيضًا
- تضم JSUT اليابانية وCSMSC الصينية نحو 10 ساعات، وتُستخدمان عادةً كمجموعتي بيانات لصوت متحدث واحد
- عند التدريب من الصفر، يكون الحد الأدنى نحو ساعة واحدة، لكن أخطاء النطق قد تزداد بحسب النموذج
- عند إجراء تدريب إضافي لنموذج مُدرّب مسبقًا، توجد تقارير تفيد بأن 30 دقيقة أصبحت تعادل تقريبًا تدريبًا من الصفر لمدة 27 ساعة
وجدتُ أيضًا دراسة درّبت Matcha-TTS باستخدام أصوات مُصطنعة فقط (جامعة شنغهاي جياو تونغ، ديسمبر 2025). وتشير إلى أن تنوع أنواع النصوص يحسن النتيجة، وأن الصوت النظيف الخالي من الضوضاء أفضل، وأن اتساق أسلوب الكلام يجعل التدريب أسهل. وبما أن البيانات المُصطنعة خالية من الضوضاء ومتسقة في أسلوب الكلام، فقد تكون أسهل للتدريب من التسجيلات الحقيقية للمدة نفسها. وربما يفسر ذلك الوصول إلى هذه النتيجة خلال 7.5 ساعات.
ما الذي واجهتُه من صعوبات
- تجمّد الحاسوب: حمّلتُ بالخطأ نموذجين بحجم 31B على GPU في الوقت نفسه لإنشاء النصوص، فامتلأت VRAM. ومنذ ذلك الحين، أصبحت القاعدة هي «نموذج واحد فقط على GPU في كل وقت»
- إفراط Gemma 4 في التفكير: كان نحو ثلثي المخرجات «تفكيرًا». وعند إيقاف التفكير، أصبح أسرع بنحو 3 مرات
- هلوسة HiggsAudio السمعية: في اختبار أولي، تابع من تلقاء نفسه بعد الصمت في نهاية الجملة بعبارة «Hvala što pratite kanal(شكرًا لمتابعتكم القناة)」، فنتج مقطع مدته 81 ثانية. يبدو أنه يتذكر عبارة ختامية من YouTube. لذلك بدأتُ أستبعد المقاطع التي يختلف طولها كثيرًا عن المتوقع
- عدم عمل Matcha-TTS على Windows: تعذر بناء بعض امتدادات C، لذا أعدتُ كتابة ذلك الجزء بلغة Python (numba)