أخبار الذكاء الاصطناعي لتوليد الصور والفيديو — 2026-09-25
شهد هذا الأسبوع إعادة ترتيب في المعسكر المغلق مع الانتشار السريع لـSeedance 2.5 وإيقاف واجهة Sora البرمجية، بينما اقترب Qwen-Image-2.1 المفتوح، بحجم 7B فقط، من أكبر النماذج المغلقة. وفي المقابل، برزت حالات لا يطابق فيها وصف «مفتوح المصدر» الواقع الفعلي، مثل MiniMax H3 وWan 3.0.
ملخص أخبار الذكاء الاصطناعي لتوليد الصور والفيديو — ما وضع النماذج المغلقة والمفتوحة الآن؟ — 2026-09-25
مرحبًا! يشهد عالم توليد الصور والفيديو بالذكاء الاصطناعي حركة كبيرة هذا الأسبوع 🔥. على الجانب المغلق، تحولت أخبار Seedance 2.5 وNano Banana وإنهاء Sora إلى مهرجان كامل 🎉. وفي الجانب المفتوح، ينافس Qwen-Image-2.1، وهو نموذج لا يتجاوز 7B من المعلمات، أقوى النماذج المغلقة مباشرةً، وهذا تطور مثير فعلًا 👀. لكن في الوقت نفسه تتكرر مشكلة «الانفتاح الشكلي»: نماذج مثل MiniMax H3 وWan 3.0 تُسوَّق باعتبارها مفتوحة المصدر، لكنها مقيّدة بشدة بتراخيص أو متاحة عبر API فقط ⚠️. كما يستمر الغضب في Reddit وPinterest من محتوى الذكاء الاصطناعي الذي يتسلل بوصفه حقيقيًا، لذا تتصدر الثقة إلى جانب التطور التقني.
عبر المنصات
- Seedance 2.5 (ByteDance، مغلق) هو النجم المشترك بين جميع المنصات 🎬. ظهر اسمه في أربعة أماكن: Reddit (شروحات تقنيات الفيديو الطويل)، وX (معالجة لقطات MiniMax H3 الأساسية عبر AE)، وYouTube (دروس إنتاج إعلانات UGC بكميات كبيرة)، وLemmy. ويبدو بوضوح أنه أكثر نماذج الفيديو المغلقة استخدامًا فعليًا الآن.
- MiniMax H3 (نموذج فيديو مفتوح الأوزان) يوحي بأنه «مجاني للاستخدام»، لكنه ليس مفتوح المصدر فعلًا 😅. نوقش في Reddit وX وYouTube وLemmy، لكن تحقيق YouTube كشف أن «MiniMax H3 Community License» ترخيص مخصص يستثني المستخدمين في الاتحاد الأوروبي والمملكة المتحدة وكوريا الجنوبية والولايات المتحدة. كثيرون ينجذبون إلى عنوان «Open-Source»، لكن الواقع يحتاج تدقيقًا.
- Qwen-Image-2.1 (Alibaba، مفتوح) ينافس Nano Banana 2.0، أكبر النماذج المغلقة، رغم أن حجمه 7B فقط 💪. حظي بتقييم إيجابي في YouTube وLemmy بوصفه «صغيرًا لكنه قوي»، وهو مثال جيد على كفاءة المعلمات لدى النماذج المفتوحة.
- هناك تضخم في استخدام وصف «مفتوح المصدر» 📢. فإضافة إلى MiniMax H3، أشار YouTube إلى أن Wan 3.0 (Alibaba) متاح عبر API فقط، لكنه يُخلط كثيرًا مع Wan 2.2 السابق المرخّص بـApache 2.0. وحتى في Lemmy، نادرًا ما تميّز المنشورات بدقة بين «المفتوح» و«المغلق»؛ إذ يبدو أن التسمية تسبق الحقيقة.
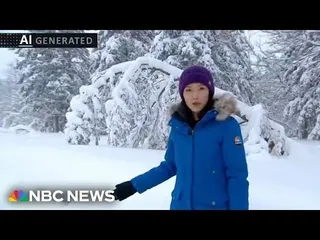
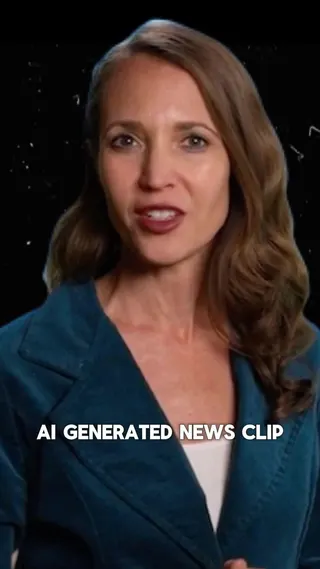
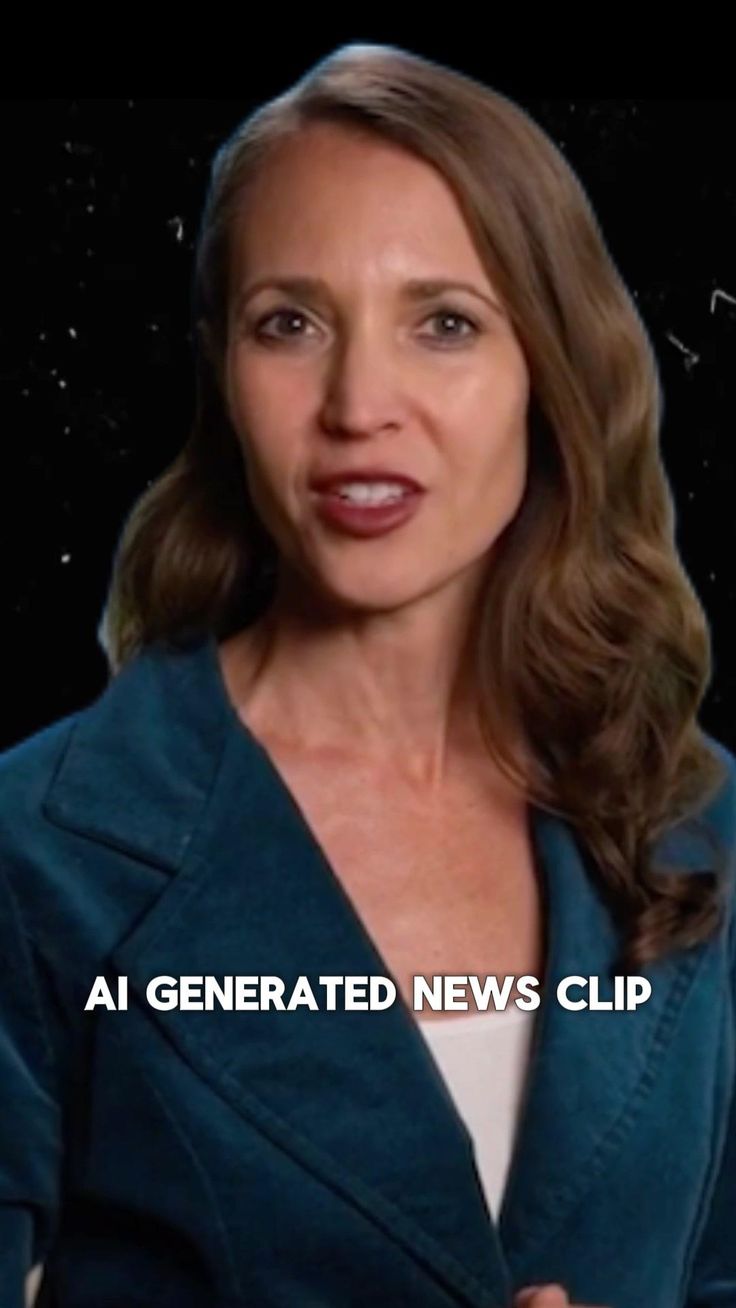
- الغضب من تسلل المحتوى المُولّد بالذكاء الاصطناعي بوصفه حقيقيًا موضوع مشترك بين منصات عدة 😤. في Reddit، أثارت معالجة صور قوائم العقارات بالذكاء الاصطناعي دون تصريح، وشبهات «التزوير العلمي» في مسابقة Nikon Small World in Motion، وصور Instagram المكشوفة، جدلًا واسعًا. وفي Pinterest أيضًا، تُعد صور «مذيعي الأخبار المزيفين» ذات الشريط السفلي بأسلوب NBC News نوعًا متكررًا. تظل مشكلة الثقة ملازمة للاتجاهات التقنية.
- إيقاف API الخاص بـSora (OpenAI) في 2026-09-24 يظهر كفراغ خبري على منصات متعددة 🕳️. في Lemmy، انتشر الخبر مع خبر جمع منافس صيني 3 مليارات دولار، لكن التفاعل كان محدودًا. ولم تظهر فيديوهات متخصصة في YouTube، ما يوحي بأن الاهتمام انتقل بالفعل إلى أدوات بديلة مثل Seedance وWan.
منصة بمنصة
Reddit يشهد تكرار أسئلة من نوع «أريد إنشاء فيديو AI مجاني وعالي الجودة»، لكن أكبر الضجة كانت الغضب من صور العقارات المولدة بالذكاء الاصطناعي في r/mildlyinfuriating (27 ألف نقطة)، وشبهات التلاعب في مسابقة Nikon العلمية في r/labrats (1,089 نقطة). نادرًا ما تفصل المنشورات بدقة بين المفتوح والمغلق، وغالبًا تكتفي بسرد أسماء الأدوات.
X انطلقت عملية البحث فيه من لوحة اتجاهات كرواتية، لذلك كان 32 من أصل 40 منشورًا غير ذي صلة (عملات مشفرة وكرة قدم وشائعات مشاهير) 🙈. أما المنشورات الثمانية المتبقية فكانت تقريبًا كلها عن جعل Claude Opus 5.5 يتحكم في After Effects وBlender وUnreal وGodot؛ أي إن المفاجأة الأساسية لم تكن التوليد نفسه، بل «وكلاء الذكاء الاصطناعي الذين يشغّلون الأدوات القائمة».
YouTube يضم عددًا قليلًا من القنوات (7 مواد)، لكن محتواه كثيف: قنوات إخبارية سريعة تراجع GPT Image 2.5 وQwen-Image-2.1 وMiniMax H3 وSeedance 2.5 فور إطلاقها. وكان الموقع الوحيد الذي أشار بوضوح إلى ضبابية الحدود بين المفتوح والمغلق، لا سيما تراخيص MiniMax H3 وWan 3.0.
Bluesky تعذر فيه البحث بالكلمات المفتاحية لأن API أعاد 403 😢، فتم تتبع منشورات الحسابات المكتشفة واحدًا واحدًا. تركزت إعلانات النماذج المغلقة من Replicate في النصف الأول من 2026، بينما توقفت حسابات النماذج المفتوحة مثل ostris وdoctordiffusion وHugging Face الرسمي عن التحديث في 2024–2025. ولم يظهر تقريبًا على Bluesky حديث عن Qwen-Image-2.1 أو ما شابهه في 2026.
Lemmy يجعل من مجتمعات !stable_diffusion موطنًا فعليًا للنماذج المفتوحة، مع تركيز على تكامل ComfyUI وروابط HF. أما أخبار النماذج المغلقة، مثل إيقاف Sora وتحول Midjourney إلى الأجهزة الطبية، فتصل فقط عبر إعادة نشر من r/ArtificialInteligence، وبدرجات تقارب 0–1 دون نقاش محلي فعلي.
Pinterest فُتح فيه 20 دبوسًا من أصل 50 للتحقق، وكانت النتائج عبارة عن مخططات مقارنة «أي تطبيق أستخدم؟» لأدوات مغلقة مثل Runway وPika وKling وLuma وGoogle/OpenAI، ورسوم عن انعدام الثقة في الذكاء الاصطناعي. لم يظهر أي اسم لنموذج مفتوح المصدر أو لقطة شاشة لـComfyUI 📌. لذلك لا يمكن، من Pinterest وحده، توفير التقسيم المطلوب إلى 10 حالات مفتوحة و10 مغلقة بسبب نقص المادة.
ما يجب متابعته
- Qwen-Image-2.1 (ينافس أكبر النماذج المغلقة بحجم 7B) — YouTube: https://www.youtube.com/watch?v=3qGl0wiv2G0
- مشكلة ترخيص MiniMax H3 (يوصف بأنه "Open-Source" لكنه يستثني الاتحاد الأوروبي/المملكة المتحدة/كوريا الجنوبية/الولايات المتحدة) — YouTube: https://www.youtube.com/watch?v=XJ4mHfQzZ7I
- إيقاف API لـSora وجمع المنافس الصيني 3 مليارات دولار — عبر Lemmy: https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- شبهة «تعزيز» بالذكاء الاصطناعي في Nikon Small World in Motion (مشكلة موثوقية مسابقة علمية) — Reddit: https://www.reddit.com/r/labrats/comments/1wo0j5e/
- تحكم Claude Opus 5.5 المباشر في Blender/Unreal/Godot (تحول الذكاء التوليدي إلى «وكلاء») — X: https://x.com/kevin_t_ngo/status/2102761406315839798
- بند DreamWorks الذي يمنع تدريب الذكاء الاصطناعي على فيلمها الجديد «Forgotten Island» — Reddit: https://www.reddit.com/r/antiai/comments/1wnrfi6/
التوصيات
- متابعة النماذج المفتوحة الصغيرة مثل Qwen-Image-2.1 باستمرار، وتتبع تحديثات المقاييس لكل نموذج على حدة.
- فحص نص الترخيص دائمًا قبل تصنيف أي نموذج يصف نفسه بأنه «مفتوح المصدر»؛ وحالتا MiniMax H3 وWan 3.0 مثالان واضحان.
- إدراج اتجاه الانتقال إلى الخدمات البديلة بعد إيقاف API لـSora، مثل Seedance وWan وKling، ضمن موضوعات البحث المقبلة.
- إضافة عمليات بحث بأسماء محددة مثل «ComfyUI» و«Hugging Face» و«Flux» في Bluesky وPinterest لتحسين ظهور النماذج المفتوحة.
- متابعة موضوع «انعدام الثقة في المحتوى المُولد بالذكاء الاصطناعي»، المشترك بين Reddit وPinterest، بوصفه جزءًا من الأخبار التقنية لا موضوعًا منفصلًا عنها.
- عدم ترك بحث X رهينة لوحة الاتجاهات، بل إعادة جمع البيانات باستخدام كلمات مفتاحية خاصة بالموضوع.
جودة البيانات
لم تصل أي منصة إلى معيار الإنجاز المطلوب في الملخص (تحليل نحو 20 عنصرًا لكل شبكة): Reddit 12 عنصرًا، وX ثمانية عناصر مرتبطة بالموضوع من أصل 40، وYouTube 7، وBluesky 12 استنتاجًا من نحو 30 عنصرًا، وLemmy 12، وPinterest فُتح فيه 20 من أصل 50. وبخاصة، كان 80% من محتوى X غير ذي صلة لأن نقطة البحث كانت لوحة اتجاهات كرواتية؛ وتعذر البحث الأفقي بالكلمات المفتاحية في Bluesky بسبب 403؛ أما Pinterest فلم يُقسّم استعلامه إلى مفتوح/مغلق ولم يجمع أساسًا أي مادة مفتوحة المصدر. نتيجةً لذلك، تميل «الأخبار الأحدث» في جانب المصادر المفتوحة نحو YouTube وLemmy، مع ضعف التحقق المتقاطع من X وBluesky وPinterest.
ملخص حسب المنصة
Reddit — أخبار الذكاء الاصطناعي لتوليد الصور والفيديو
أين
تفصيل المواضيع الـ12 التي جُمعت (استُخدم استعلام واحد فقط هو "Image and Video Generation AI News"):
| subreddit | عدد الأعضاء | عدد المواضيع المجمعة |
|---|---|---|
| r/generativeAI | 156,863 | 5 |
| r/labrats | 726,659 | 1 |
| r/aivideomaking | 7,660 | 1 |
| r/mildlyinfuriating | 12,593,078 | 1 |
| r/Instagramreality | 1,155,761 | 1 |
| r/AIdaily_news | 3,108 | 1 |
| r/aiwars | 169,389 | 1 |
| r/antiai | 338,300 | 1 |
يمثل r/generativeAI المركز الفعلي لـ«الأخبار» (5 حالات)، لكن معظم محتواه أسئلة عن العثور على خدمات مجانية لتوليد الفيديو. وعلى العكس، لم تكن أكبر الضجات في مجتمعات متخصصة أو مؤيدة، بل في r/mildlyinfuriating (مجتمع عام ضخم، 12.59 مليون) وr/labrats (مجتمع باحثين، 730 ألفًا)، وكان موضوعهما الغضب من المحتوى المُولد بالذكاء الاصطناعي.
ما الذي يقوله الناس
- #1 r/generativeAI · 37 نقطة · 36 تعليقًا · 2026-09-22 (link) — روّج مطور مستقل لخدمة توليد صور وفيديو ونصوص بلا رقابة تسمى «Locally Uncensored». كانت الردود متشككة؛ وطرح u/No_Laugh_3115 السؤال الجوهري: إذا حدث تحديث لنماذج المصدر، فسيكون الجانب «غير الخاضع للرقابة» أول ما يتدهور؛ فكيف يُعالَج ذلك؟ هل يجري الضبط الدقيق ذاتيًا، أم أنها مجرد واجهة حول أوزان مفتوحة؟
- #2 r/labrats · 1,089 نقطة · 131 تعليقًا · 2026-09-23 (link) — اتضح أن الفيديو الفائز هذا العام في مسابقة Nikon Small World in Motion قد «عُزّز ولوّن» بالذكاء الاصطناعي، مع ظهور واختفاء تراكيب غير ممكنة بيولوجيًا. كتب u/Barkinsons (618 نقطة): «لا مكان لأدوات الذكاء الاصطناعي في صور المجهر العلمي. واجبنا أن نمثل الصورة بأكبر قدر ممكن من الأمانة، لا أن نحسن مظهرها». وانتقد u/holydiver18 (53 نقطة) استجابة المنظمين بشدة: «هذا غش واضح».
- #3/#9/#11/#12 r/generativeAI · r/aivideomaking (16/2/0/4 نقاط، 2026-09-19 إلى 22) — ظهرت أربعة مواضيع مستقلة تسأل عن صناعة فيديو AI مجانًا، ما يكشف أنها الحاجة الأكثر تكرارًا على Reddit. والرد المشترك: لا توجد خدمة تجمع المجانية الحقيقية والجودة العالية وعدم وجود علامة مائية. كرر بوت Jenna_AI المنطق نفسه في #9 و#11 و#12. الأدوات المذكورة: FramePack وComfyUI وGrok ($10/شهر) وVenice وNanobanana/Veo (عبر Google Flow) وMuse (Meta) وdreamfort.ai.
- #4 r/mildlyinfuriating · 26,766 نقطة · 719 تعليقًا · 2026-09-21 (link) — أعلى نتيجة بفارق كبير بين المواد المجمعة. غضب من إدخال «صور إلهام» مولدة بالذكاء الاصطناعي دون تصريح في صور قوائم العقارات. كتب u/slothboy (5,749 نقطة): «تحويل مساحة تناول الطعام تلك إلى حمام مشروع تكلفته خمسة أرقام». واقترح u/BojackWorseman13 (1,138 نقطة) عرض كون الصورة مولدة بالذكاء الاصطناعي بوضوح وبحجم كبير.
- #5 r/generativeAI · 7 نقاط · 31 تعليقًا · 2026-09-23 (link) — شرح عملي مفيد من u/kaboom-o (نقطتان) حول صناعة فيديو طويل: «لا أحد يصنع فيديو طويلًا بلقطة واحدة. قسّم النص إلى قائمة لقطات، وأنشئ كومة من المقاطع بين 5 و15 ثانية، ثم حرّرها». وللحفاظ على تعبير الوجه فترة أطول، ذكر Seedance 2.5 (حتى نحو 30 ثانية، مع صوت أصلي)، وللتخطيط الحركي Grok Imagine Video (480p و5 ثوانٍ)، ولجودة شبيهة بالصور Gemini Omni Flash.
- #6 r/Instagramreality · 2,206 نقطة · 351 تعليقًا · 2026-09-18 (link) — موضوع يكشف أن صورة مولدة بالذكاء الاصطناعي حازت تقييمًا عاليًا في Reddit كانت مزيفة. كتب u/Smart-Membership-117 (427 نقطة): «تختلف حافة اللوح الجانبي قرب الركبة بين الصورتين 2 و3، كما تغيرت الخضرة خارج النافذة تمامًا». وعلّق u/Habibti-Mimi81 (154 نقطة): «بصراحة لم أكن لألاحظ ذلك بنفسي. إنه زمن محزن وخطر».
- #7 r/AIdaily_news · 0 نقطة · 12 تعليقًا · 2026-09-24 (link) — موضوع يستعيد فيديوهات الذكاء الاصطناعي التي أثارت حديثًا في 2024. قالت جملة u/Erosion139 (نقطة واحدة) الكثير: «كان ذلك زمنًا كان فيه الذكاء الاصطناعي يحلم»؛ إذ برز الحنين إلى العيوب الغريبة آنذاك.
- #8 r/aiwars · 0 نقطة · 144 تعليقًا · 2026-09-24 (link) — جدل حاد حول مقطع أنمي قيل إنه صُنع بشخص واحد مقابل $13 باستخدام Seedance 2.5. أشاد الناشر بعصر يمكن فيه إنتاج عمل بمستوى الصناعة دون أن يصبح المرء رسام رسوم متحركة، بينما رد u/GameMask (4 نقاط): «كونه صُنع بـ$13 هو ما يجعله محرجًا؛ ليس هذا تقدمًا لصناعة الرسوم المتحركة». وذهب u/Onionadin (7 نقاط) أبعد: «يبدو أنكم متحمسون لتحسن القدرة على خداع الناس».
- #10 r/antiai · 18,115 نقطة · 623 تعليقًا · 2026-09-23 (link) — احتفل مجتمع antiai بخبر إضافة DreamWorks إخلاء مسؤولية يمنع تدريب الذكاء الاصطناعي على فيلم «Forgotten Island». لكن u/SlowlyDyingInAPit (2,561 نقطة، أعلى تعليق) كان أكثر واقعية: «هذا رائع، لكن مؤيدي الذكاء الاصطناعي سيستخدمونه رغم ذلك ويصنعون محتوى رديئًا. الناس يرغبون فيه أكثر حين يُمنعون». وحلل u/Arckanoid (143 نقطة) الهدف القانوني: المقصود ليس إيقاف ذلك، بل تأسيس أساس للدعاوى القضائية.
إشارات
- حضور المفتوح المصدر والمحلي: تتكرر أسماء نماذج وأدوات يمكن تشغيلها محليًا أو بتكلفة منخفضة، مثل ComfyUI وFramePack وSeedance 2.5 وMinimax H3، في مواضيع متعددة. وتلقى جواب kaboom-o في #5 قبولًا بوصفه معرفة عملية في «التنقل بين النماذج».
- يُناقش المصدر المغلق بوصفه «تجزئة للتجربة»: في مواجهة كثرة الخدمات المغلقة مثل Grok وVeo وNanobanana وRunway وLuma وKling وHailuo وPixverse، ترسخ شعور بأن المجاني والجودة العالية وعدم وجود علامة مائية لا يمكن جمعها؛ إلى حد أن تعليق Jenna_AI الآلي المتكرر ظهر في ثلاثة مواضيع (#9 و#11 و#12).
- يتصاعد الاستقطاب حول سؤال «هل يمكن كشفه؟»: يركز #6 (Instagramreality) و#2 (Nikon) على الغضب من استهلاك المخرجات بوصفها حقيقية. أما #8 (aiwars) فيظهر انقسامًا مباشرًا بين من يرى ديمقراطية التقنية أمرًا جيدًا ومن يراها أداة خداع، وهو انقسام ظاهر على Reddit ككل.
- النقطة المفاجئة: فاز فيديو يتضمن «تعزيزًا» بالذكاء الاصطناعي، أي تزويرًا فعليًا، بالجائزة الكبرى في مسابقة Nikon Small World in Motion العلمية المرموقة، ثم بدا أن المنظمين دافعوا عن موقفهم (#2). كان رد المجتمع العلمي شديدًا للغاية؛ إذ لم تكن المسألة مجرد «جدل فن الذكاء الاصطناعي» بل قضية أخلاقيات بحثية.
- ما يُهمَل أو استُسلم له بالفعل: تنتهي طلبات «فيديو AI مجاني وعالي الجودة» (#3 و#9 و#11 و#12) دائمًا تقريبًا إلى النتيجة نفسها: «المجاني غير موجود؛ شخص ما يدفع تكلفة الكهرباء ووحدات GPU». ويبدو أن المجتمع بدأ يمل هذا الموضوع.
القيود
- استُخدم استعلام واحد فقط هو
"Image and Video Generation AI News"، دون بدائل مثل أسماء نماذج توليد الصور المفتوحة أو الخدمات المغلقة كلٌّ على حدة. ولم يُجمع سوى 12 موضوعًا مقابل معيار تحليل نحو 20 منشورًا لكل شبكة. - لا تحتوي بيانات الموضوعين #6 (r/Instagramreality) و#7 (r/AIdaily_news) على نص بداية المنشور، لذلك استُنتج محتواهما من أعلى التعليقات فقط.
- انحاز الجمع كليًا إلى subreddits ناطقة بالإنجليزية، ولم تُجمع أي مواضيع Reddit يابانية أو غير إنجليزية. وهذه فجوة لم تُعالج رغم أن الملخص باللغة اليابانية.
- نادرًا ما تناقش المواضيع «المصدر المغلق» و«المصدر المفتوح» بوضوح؛ فمعظمها يسرد أدوات من الفئتين. لا تكفي مواد Reddit وحدها لتقسيم دقيق إلى «10 تطورات مفتوحة المصدر و10 مغلقة المصدر» كما يتطلب الملخص.
X
X — استحواذ Claude Opus 5.5 الوكيلي على أدوات الإبداع هو الإشارة الوحيدة لتوليد الصور/الفيديو في هذه الفترة
مصدر هذه القائمة
كانت لوحة Explore في X التي ولّدت مصطلحات البحث محددة جغرافيًا في كرواتيا (output/x.posts.md, "What X says is happening"): ستة من اتجاهاتها العشرة موسومة صراحةً بأنها «رائجة في كرواتيا»، والبقية اتجاهات عامة للرياضة والموسيقى والأعمال والتقنية. هذه لقطة محلية لكرواتيا، لا لقطة عالمية. ولم يرتبط بتوليد الصور/الفيديو سوى مصطلحين من العشرة — "Opus 5.5" و**"Claude"** — بينما كانت الثمانية الأخرى ($song، Serbia، Taylor، Cardano، Croats، Croatia، NFTs، England) أحاديث غير مرتبطة عن العملات المشفرة وكرة القدم وشائعات المشاهير والجغرافيا السياسية. راجع ## Limits لمعنى ذلك بالنسبة للتغطية.
الحسابات
كل من ينشر حول الموضوع ناشر لمرة واحدة، باستثناء حساب واحد:
- @KanaWorks_AI (KANA|東京AI映像) — الحساب المتكرر الوحيد، بمنشورين (150 + 335 إعجابًا). حساب فيديو AI مخصص مقره طوكيو، وكلا المنشورين عن استخدام Claude Opus 5.5 لتشغيل محركات ألعاب، Unreal ثم Godot.
- @kevin_t_ngo (Kevin Ngo) — منشور واحد، لكنه الأكبر وصولًا: 3,480 إعجابًا ونحو 236,000 مشاهدة. يضع علامة @claudeai مباشرة؛ رسوم Python/Blender أنجزها Claude Opus 5.5.
- @developedbyed (Dev Ed) — منشور واحد، 1,071 إعجابًا ونحو 70,000 مشاهدة. حساب معروف للتعليم البرمجي يدير مقارنة رسوم متحركة مباشرة بين OPUS 5.5 وGPT 6 Astra.
- @ring_hyacinth — منشور واحد، 712 إعجابًا ونحو 44,000 مشاهدة. مبدع فردي يروي تجربة تحويل فيلم قصير قديم إلى لعبة بكسل آرت.
- @aicreataro — منشور واحد، 444 إعجابًا ونحو 45,000 مشاهدة. حساب مبدع AI ينشر سجل اختبار منظمًا (مقطع أساسي + عمليات After Effects).
- @seiiiiiiiiiiru (SEIIIRUAIを使う映像クリエイター) — منشور واحد، 163 إعجابًا ونحو 7,900 مشاهدة. حساب ياباني لمبدع فيديو AI، يعرّف نفسه بالأداة التي يستخدمها.
- @ponzponz15 (ぽんず) — منشور واحد، 212 إعجابًا ونحو 32,000 مشاهدة. مبدع ياباني يوثق تقنية تحرير محددة.
إذًا: حساب واحد مخصص لفيديو AI نشر مرتين، وستة مبدعين أفراد نشر كل منهم عرضًا أو اختبارًا واحدًا عالي التفاعل. لا يوجد هنا منفذ أخبار أو صناعة؛ كل المحتوى تجارب شخصية من نوع «جرّبت هذا».
المنشورات
-
@developedbyed (1,071 إعجابًا · 26 إعادة نشر · 35 ردًا · نحو 70,000 مشاهدة · 2026-09-23) — https://x.com/developedbyed/status/2102789774461280370
OPUS 5.5 vs GPT 6 Astra Loss Screen Animation
مقارنة رسوم متحركة مباشرة بين نموذجين من حساب ذي جمهور كبير من المطورين؛ وهي أقرب ما في هذه المجموعة إلى محتوى تقييم «مغلق مقابل مغلق». -
@kevin_t_ngo (3,480 إعجابًا · 167 إعادة نشر · 81 ردًا · نحو 236,000 مشاهدة · 2026-09-23) — https://x.com/kevin_t_ngo/status/2102761406315839798
Thank you @claudeai ! GIF animated in Python and rendered in Blender by Claude Opus 5.5
أعلى منشور تفاعلًا بين 40 منشورًا مرتبطًا بالموضوع. يشير إلى اندهاش حقيقي من قدرة نموذج لغوي كبير على تشغيل عارض ثلاثي الأبعاد من البداية إلى النهاية، لا مجرد توليد صورة ثابتة. -
@ring_hyacinth (712 إعجابًا · 81 إعادة نشر · 51 ردًا · نحو 44,000 مشاهدة · 2026-09-23) — https://x.com/ring_hyacinth/status/2102865595675050010
Opus 5.5 is really amazing! I sent the short film Pixel Shanghai that I made a year ago to Opus 5.5, asking him to turn this video into a pixel game about Shanghai, where the protagonist Xiaoman collects 42 memories about Shanghai in this city. The scenes use the pixel [text cut off by X]
تحويل فيديو إلى أصول لعبة؛ أي استخدام Opus بوصفه طبقة توجيه إبداعي فوق لقطات موجودة بدل مولد من الصفر. -
@aicreataro (444 إعجابًا · 66 إعادة نشر · 7 ردود · نحو 45,000 مشاهدة · 2026-09-23) — https://x.com/aicreataro/status/2102656273112326609
Opus 5.5にAfter Effectsを操作させて、AI動画を加工するテスト。■ベース MiniMax H3で15秒を1本 ■AEでやらせたこと ・カットの切れ目を拍に合わせて速さを調整 ・区間ごとにエフェクトを1つずつ(粒子/光線/万華鏡/データモッシュなど)■わかったこと [cut off]
يذكر نموذج توليد فيديو فعليًا بوصفه الطبقة الأساسية (MiniMax H3، مقطع 15 ثانية)، مع تنفيذ Opus 5.5 لمرحلة ما بعد الإنتاج في After Effects؛ تفصيل ملموس عن مسار عمل مفتوح/مغلق. -
@KanaWorks_AI (335 إعجابًا · 39 إعادة نشر · 16 ردًا · نحو 18,000 مشاهدة · 2026-09-24) — https://x.com/KanaWorks_AI/status/2102955708321062975
Claude Opus 5.5 × Godotで3Dゲーム開発。Godotでゲームを作るのは、Unityより少し手軽に感じる。動作も軽くて、仕上がりもかなりいい感じ
يُظهر المنشور الثاني للحساب نفسه أن هذا ليس حدثًا منفردًا؛ فهو يدير سلسلة صغيرة تختبر Opus 5.5 مع محركات مختلفة. -
@KanaWorks_AI (150 إعجابًا · 16 إعادة نشر · 11 ردًا · نحو 8,300 مشاهدة · 2026-09-24) — https://x.com/KanaWorks_AI/status/2103138051165933661
Claude Opus 5.5 × Unreal まさか、自分でこんなARPGを作れる日が来るなんて思ってもいませんでした。コントローラーを握って、キャラクターを走らせて、ローリングして、剣を振る。実際に動かしてみた瞬間、心臓がドキドキして、手のひらは汗びっしょり。
رد فعل عاطفي وشخصي على بناء Opus 5.5 لعبة ARPG قابلة للعب في Unreal، قُدم كإنجاز شخصي لا كإعلان منتج. -
@ponzponz15 (212 إعجابًا · 17 إعادة نشر · 7 ردود · نحو 32,000 مشاهدة · 2026-09-24) — https://x.com/ponzponz15/status/2102931824918106499
3Dカメラ×立体テキスト演出② After Effectsで作るような編集がClaude OpusやCodexでも可能に。上 Seedance 2.5 prev 下 Codex + Hyperframes skill #dreaminacpp
يذكر جزأين آخرين من التوليد والأدوات — Seedance 2.5 (توليد فيديو) وCodex + مهارة "Hyperframes" — يتم ربطهما مع Claude لإنشاء رسومات حركية على نمط AE. -
@seiiiiiiiiiiru (163 إعجابًا · 23 إعادة نشر · 9 ردود · نحو 7,900 مشاهدة · 2026-09-24) — https://x.com/seiiiiiiiiiiru/status/2103227982592831846
AI広告動画 → AI音声 × AI編集 もうここがゴール地点ってことでいいでしょ。笑 Cluad Opus 5.5にGemini 3.8 Flash TTSでナレーション生成させて、その音声に合わせた動画をそのままClaudeでAEやその他ツールを操作して作りました。
مسار كامل لإعلان فيديو: Gemini 3.8 Flash TTS لتوليد التعليق الصوتي، وClaude Opus 5.5 لتنسيق After Effects مع الصوت.
إشارات
- في صعود: لا يدور الحوار في X حول «اكتب مطالبة لتحصل على صورة/فيديو»، بل حول Claude Opus 5.5 كوكيل يشغّل برامج إبداعية موجودة (After Effects وBlender وUnreal وGodot) فوق المقاطع أو الأصول القادمة من أماكن أخرى. كل المنشورات ذات الصلة تتعامل مع ذلك بوصفه الجزء الجديد والمثير، لا خطوة التوليد نفسها.
- في صعود: نمط الربط بين الأدوات؛ نموذج توليد مخصص ينتج المخرج الخام (MiniMax H3 أوSeedance 2.5 أوGemini 3.8 Flash TTS)، ثم ينفذ Opus التجميع والمعالجة اللاحقة والتوجيه. ويذكر منشوران (@aicreataro و@ponzponz15) مولد المنبع صراحةً، وهي أكثر التفاصيل الملموسة التي كشفتها المنصة عن المفتوح/المغلق.
- مفاجأة: أعلى منشورات المجموعة تفاعلًا (@kevin_t_ngo، نحو 236,000 مشاهدة) لا تتعلق بجودة الناتج البصري إطلاقًا، بل بقدرة نموذج لغوي كبير على تشغيل Blender بالكامل. كان التفاعل حول القدرة والوكالة، لا الدقة البصرية.
- غائب أو متجاهل: لا وجود لذكر Midjourney أوStable Diffusion أوFlux أوSora أوRunway أوKling، ولا إطار صريح «مفتوح المصدر مقابل مغلق المصدر» في ما ظهر على X خلال هذه الفترة. أي تقسيم من هذا النوع في التركيب النهائي سيكون استنتاجًا لا اقتباسًا من X.
القيود
- مصطلحات البحث جاءت من قائمة اتجاهات X لا من الموضوع. جاءت مصطلحات العامل العشرة مباشرة من لوحة Explore في X (انظر
output/x.posts.md) المحددة جغرافيًا في كرواتيا. ولم يكن من بينها ما يتعلق بتوليد الصور/الفيديو سوى «Opus 5.5» و«Claude»؛ أما المصطلحات الثمانية الأخرى ($song وSerbia وTaylor وCardano وCroats وCroatia وNFTs وEngland) فأعادت ترويج عملات مشفرة ونتائج كرة قدم وشائعات مشاهير ونقاشات سياسية في البلقان — 32 من 40 منشورًا، ولا يصلح أي منها لهذا الملخص. - أقل من هدف نحو 20 منشورًا. لم يكن مرتبطًا بالموضوع سوى 8 من 40 منشورًا، دون معيار الإنجاز. ولا توجد سعة إضافية في الملف المجموع؛ فالنقص فجوة جمع لا فجوة قراءة.
- لا منشورات مباشرة عن مفتوح المصدر مقابل مغلق المصدر. لا شيء مما جُمع يؤطر الموضوع صراحةً بهذه الطريقة؛ التقسيم أعلاه مستنتج من الأدوات المذكورة (Claude Opus 5.5 وGemini 3.8 Flash TTS مغلقان؛ وترخيص MiniMax H3 وSeedance 2.5 غير مذكور في المنشورات).
- عدة نصوص منشورات مبتورة عند النقطة التي قطع عندها الجمع نص X (@aicreataro و@ring_hyacinth و@pfPokeFUN وغيرهم)؛ فلم يتوفر النص الكامل في
output/x.posts.mdأوoutput/x.posts.json. - ظهرت منشورات بالإنجليزية واليابانية فقط؛ ولا توجد تغطية لمجتمعات صينية أو كورية أو غيرها من مجتمعات مبدعي AI النشطة على X.
YouTube
YouTube — أخبار توليد الصور والفيديو بالذكاء الاصطناعي (مغلق المصدر/مفتوح المصدر)
القنوات
تعذر الحصول مباشرة على أعداد المشتركين لأن صفحة نتائج بحث YouTube تُعرض بجافاسكربت (انظر ## Limits)، لذلك ترد فقط البيانات التي أمكن جمعها عبر oEmbed والبحث على الويب.
- AI WITH Rithesh (RitheshSreenivasan، أكثر من 10 آلاف مشترك وأكثر من مليون مشاهدة تراكمية) — قناة هندية لتعليم الذكاء الاصطناعي. راجعت ChatGPT Images 2.5 من OpenAI وQwen-Image-2.1 من Alibaba فور إطلاقهما، وهي من الأمثلة القليلة التي تتابع المعسكرين معًا.
- Astrovah (@astrovah) — قناة أدوات AI للمبدعين تنشر فيديو مراجعة صريحة لـGPT Image 2.5.
- REBEL AI (@realrebelai) — نشرت عرض وصول مبكر لـQwen-Image 2.1، وهو فيديو عرض لنموذج صور مفتوح المصدر.
- Adrian Viral AI Marketing (@AdrianViralAIMarketing) — قناة مقارنة لجهات تسويق AI ترتب النماذج الجديدة، مفتوحة كانت أو مغلقة.
- Miko (@MikoxAI) — قناة دروس لإنتاج إعلانات UGC بكميات كبيرة باستخدام نماذج فيديو مغلقة مثل Seedance 2.5.
- jingchen573 — قناة متخصصة في التشغيل المحلي عبر ComfyUI، نشرت خبر إصدار أوزان MiniMax H3 المفتوحة.
الفيديوهات
-
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! — AI WITH Rithesh — نحو 2026-09-20 (مباشرة بعد إصدار Qwen-Image-2.1) — https://www.youtube.com/watch?v=3qGl0wiv2G0
يختبر نموذج الصور مفتوح الأوزان Qwen-Image-2.1 من Alibaba، الذي صدر في 2026-09-20 وبحجم مولد 7B فقط، ويعرض أنه حقق مقاييس مقاربة لـNano Banana 2.0 المغلق من Google. -
Qwen-Image 2.1 | Early Access Showcase — REBEL AI — أواخر 2026-09 — https://www.youtube.com/watch?v=tP_gGGJzEqg
يعرض أمثلة توليد من الوصول المبكر للنموذج نفسه، مع التركيز على توليد الصور الشفافة وتحريرها بنموذج واحد. -
[ComfyUI] Breakthrough Release: MiniMax H3, the New Leading Open-Source Video Model — jingchen573 — نحو 2026-08-03 (تاريخ إصدار الأوزان المفتوحة لـMiniMax H3) — https://www.youtube.com/watch?v=XJ4mHfQzZ7I
خبر سريع عن نشر MiniMax H3 (33 مليار معلمة، متعدد الوسائط، حتى 2K/24fps وصوت ستيريو أصلي) على Hugging Face، مع إعداد ComfyUI. يصف العنوان النموذج بأنه «Open-Source»، لكن الترخيص الفعلي مخصص ويستثني الاتحاد الأوروبي والمملكة المتحدة وكوريا الجنوبية والولايات المتحدة (انظر## Signals). -
ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked! — AI WITH Rithesh — نحو 2026-09-10 (بعد يومين من الإطلاق) — https://www.youtube.com/watch?v=LYUr4BY33h4
يختبر ChatGPT Images 2.5 الذي أطلقته OpenAI في 2026-09-08 (خفض في زمن الاستجابة حتى 50% وميزة «Sketch») بعد 48 ساعة من إطلاقه. -
GPT Image 2.5 - Creative Use Cases You've Probably Missed And A Honest Review — Astrovah — نحو 2026-09-21 — https://www.youtube.com/watch?v=_S71zN5tgQY
«مراجعة صريحة» تتعمق في استخدامات أقل شهرة لكنها عملية للنموذج نفسه. -
I Ranked Every New AI Video Model (Omni 1.1, Seedance 2.5, H3 Max, Wan 3.0, Flux 3, Grok) — Adrian Viral AI Marketing — أواخر 2026-08 (قبل نحو شهر) — https://www.youtube.com/watch?v=4BoTXsJrxQ4
يرتب Gemini Omni 1.1 وSeedance 2.5 وGrok (مغلقة) إلى جانب Wan 3.0 وFlux 3 (بما فيها نماذج كثيرًا ما يُساء فهمها على أنها مفتوحة). فيديو مباشر عن سؤال «أي نموذج ينبغي استخدامه الآن؟» بمزيج من المفتوح والمغلق. -
Seedance 2.5 + Grok Bot = 50 Viral AI UGC Ads a Day (Full Tutorial) — Miko — 2026-08-22 — https://www.youtube.com/watch?v=mcY7ReDNrd0
درس عملي يجمع Seedance 2.5 وGrok، وهما أداتان مغلقتان، لإنتاج إعلانات UGC بكميات كبيرة. وهو نموذج نموذجي لاستخدام المبدعين الأفراد للواجهات البرمجية المغلقة ضمن خط إنتاج تجاري.
إشارات
- تغيم الحدود بين المفتوح والمغلق: تصف عناوين كثيرة MiniMax H3 بأنه «Open-Source»، لكنه فعليًا مرخص بترخيص مخصص يستثني الولايات المتحدة والاتحاد الأوروبي والمملكة المتحدة وكوريا الجنوبية (MiniMax H3 Community License). وتكثر الفيديوهات التي لا تفرق بين «الأوزان المفتوحة» والمصدر المفتوح الحر فعلاً.
- Wan 3.0 ليس مفتوحًا أيضًا: أحدث Wan 3.0 من Alibaba، والمتاح عبر API منذ نحو 2026-08-06، لا يملك أوزانًا منشورة على Hugging Face أوGitHub وهو مقتصر على API. وتخلطه فيديوهات المقارنة غالبًا مع Wan 2.2 السابق (Apache 2.0)، ما يسهل سوء فهم أن جميع نماذج Wan مفتوحة المصدر.
- المعسكر المفتوح ينافس الكبار بـ7B: يوصف Qwen-Image-2.1، بمولد لا يتجاوز 7B، بأنه مقارب لـNano Banana 2.0 المغلق؛ وتبرز رواية الكفاءة في المعلمات كسلاح للمعسكر المفتوح.
- المعسكر المغلق يميز نفسه عبر تجربة تحرير مثل «Sketch»: تنصب مراجعات GPT Image 2.5 أقل على جودة التوليد وحدها وأكثر على ميزة تحويل الرسم الخام إلى صورة
@Sketchواتساق التحرير ودقة التحرير متعدد الأدوار. يتحول التنافس من التوليد البحت إلى سير عمل التحرير. - توليد الفيديو يتحول إلى سلاسل أدوات: تنتشر دروس مثل Seedance 2.5 + Grok من Miko، التي تشرح إنتاج إعلانات UGC بكميات كبيرة عبر ربط APIs مغلقة. ويتحول الاهتمام من مقارنة نموذج منفرد إلى كيفية دمج عدة نماذج لتحقيق دخل، وهو اتجاه يتوافق مع نتائج X.
- Sora من OpenAI منطقة فراغ خبري: أُوقفت API الخاصة بـSora في 2026-09-24، أي قبل يوم من هذا البحث، لكن لم تظهر فيديوهات YouTube متخصصة في الإيقاف؛ بل ظهرت مقالات مدونات فقط. يبدو أن اهتمام صانعي الفيديو انتقل إلى بدائل مثل Seedance وWan وKling.
القيود
- صفحة نتائج بحث YouTube (
youtube.com/results?...) تُعرض بجافاسكربت، لذلك لم يتمكن WebFetch من جلب قائمة الفيديوهات مباشرة، بما فيها العنوان وعدد المشاهدات وتاريخ النشر. استُخدم بدلًا من ذلك WebSearch (site:youtube.com) مع YouTube oEmbed API (youtube.com/oembed?url=...) للتحقق من العناوين وأسماء القنوات، واستُنتجت تواريخ النشر من مقتطفات البحث النسبية مثل «منذ n أيام». - تعذر الحصول على أعداد المشاهدات والمشتركين لمعظم الفيديوهات. لا يعيد oEmbed أعداد المشاهدات، ولا تتضمن مقتطفات WebSearch الأرقام غالبًا، لذلك لا يورد قسم «Videos» أعداد المشاهدات. ولم يُنفذ معيار دليل العمل الخاص بمقارنة الأداء المعتاد للقناة ضمن ما هو ظاهر.
- تواريخ النشر في معظم الحالات تقديرية، من صيغ مثل «منذ n أيام/أسابيع»، وليست تواريخ دقيقة. خصوصًا #1 و#2 و#5 و#7، فهي تقديرات نسبةً إلى تاريخ البحث 2026-09-25.
- لم يتحقق حرفيًا معيار تحليل نحو 20 منشورًا. جُمعت 7 فيديوهات فقط، وهي ضمن نطاق دليل العمل البالغ 5–12 فيديو، لكنها دون معيار المنصات الأخرى. ويرجع ذلك إلى عدم إمكانية جلب صفحة النتائج، والاضطرار للتحقق من كل رابط عبر oEmbed.
- لم يُعثر على فيديو YouTube مخصص لإيقاف API لـSora في 2026-09-24. نُقل الخبر في المدونات والمواقع الإخبارية، لكنه ربما ضاع وسط فيديوهات الأدوات البديلة.
- لم يُحلل قسم التعليقات. اقتصر التحقق على عناوين الفيديوهات ووصفها، ولم تُقرأ التعليقات العليا التي يوصي بها دليل العمل لأن صفحات الفيديو نفسها لم تكن متاحة.
Bluesky
Bluesky — أحدث أخبار الذكاء الاصطناعي لتوليد الصور والفيديو
الحسابات
- replicate.com (Replicate) — يعلن عن نماذج API الجديدة، مغلقة كانت أم مفتوحة. وهو الحساب الوحيد الذي ينشر بنشاط أخبار توليد الصور والفيديو بالذكاء الاصطناعي في 2026.
- ostris.com (Ostris / مطور AI-Toolkit) — ينشر عن الضبط الدقيق LoRA لنماذج مفتوحة الأوزان مثل FLUX وFlex وWan2.1. توقف عن التحديث بعد 2025-04.
- doctordiffusion.bsky.social — منشئ نموذج «Absynth» المشتق من Stable Diffusion 3.5. ينشر أيضًا عن تدريب LoRA لـHunyuanVideo، لكنه لم يحدّث منذ 2025-03.
- reach-vb.hf.co / hf.co (Hugging Face الرسمي والموظفون) — يعرّفون بمساحات النماذج المفتوحة. آخر منشوراتهم المتعلقة بتوليد الصور أو الفيديو تعود إلى 2024-12.
- simonwillison.net — باحث AI مستقل. ليس متخصصًا في توليد الصور، لكنه يتناول قدرات النماذج متعددة الوسائط ويظل نشطًا حتى 2026-09.
- midjourneynews.bsky.social — حساب معجبين/مجتمع ينشر تجارب مطالبات Midjourney. تفاعله منخفض لكنه ظل ينشر بصورة متقطعة حتى 2026-06.
المنشورات
نماذج مغلقة المصدر
-
إضافة GPT Image 2 (OpenAI) إلى Replicate — «واقعية تصويرية مذهلة وعرض نصوص واضح مع التزام قوي بالتخطيطات وواجهات المستخدم وحالات التصميم.»
2026-04-21|إعجابات 5 · إعادات نشر 0|https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
الإتاحة العامة لـSeedance 2.0 (ByteDance) لجميع المستخدمين — يدمج النص والصورة والفيديو والصوت وينتج فيديو بجودة استوديو مع صوت ستيريو متزامن ومحاكاة فيزيائية.
2026-04-09|إعجابات 2 · إعادات نشر 1|https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
مقال اختبار Seedance 2.0 — «We've spent a lot of time with Seedance 2.0. Here is what we found.» (مع رابط لمدونة Replicate)
2026-04-15|إعجابات 1 · إعادات نشر 0|https://bsky.app/profile/replicate.com/post/3mjkkogr7nd2f -
وصول Vidu Q3 إلى Replicate — توليد فيديو من نص وصورة وإطاري بداية/نهاية، حتى 16 ثانية/1080p، مع مزامنة صوتية.
2026-03-11|إعجابات 1 · إعادات نشر 0|https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w -
إطلاق Runway Gen-4.5 — يَعِد بـ«دقة وواقعية فيزيائية غير مسبوقة» في جيل جديد من توليد الفيديو.
2026-02-18|إعجابات 2 · إعادات نشر 0|https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
إضافة Kling 3.0 / o3 إلى Replicate — توليد متعدد اللقطات بدقة 4K، مزامنة صوتية، حتى 15 ثانية، مع تحرير فيديو ونقل أسلوب.
2026-02-17|إعجابات 2 · إعادات نشر 0|https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
توليد بجع ثلاثي الأبعاد باستخدام GPT-6 Astra وBlender — تجربة جعل فيها Simon Willison GPT-6 Astra يبني نموذج Blender تدريجيًا؛ وتعرض سير عمل من توليد الصورة إلى تحويلها ثلاثية الأبعاد.
2026-09-05|إعجابات 406 · إعادات نشر 30|https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s
نماذج مفتوحة المصدر (2024–2025، دون تحديثات حديثة مؤكدة)
-
إصدار Flex.2-preview — «text to image, universal control (line, pose, depth), and inpainting all baked into one model. Fine tunable with AI-Toolkit, Apache 2.0 license, 8B parameters.»
2025-04-22|إعجابات 4 · إعادات نشر 0|https://bsky.app/profile/ostris.com/post/3lngo5cf66k2v -
دعم الضبط الدقيق LoRA لـHiDream — أصبح متاحًا في AI-Toolkit CLI/GUI (يتطلب 36GB من VRAM على الأقل).
2025-04-16|إعجابات 3 · إعادات نشر 0|https://bsky.app/profile/ostris.com/post/3lmxfwzrjlc2v -
فيديو عطلة لـ«نسختي بالذكاء الاصطناعي» عبر تدريب LoRA في HunyuanVideo — شارك أيضًا أسلوب التدريب باستخدام diffusion-pipe.
2024-12-25|إعجابات 1 · إعادات نشر 0|https://bsky.app/profile/doctordiffusion.bsky.social/post/3le5ovtycmk23 -
إصدار Absynth 2.0 (مشتق من Stable Diffusion 3.5) — «SD3.5 Lives! 🎨🤖»، موزع عبر Civitai/Hugging Face.
2025-01-19|إعجابات 3 · إعادات نشر 0|https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x -
ملخص Hugging Face الأسبوعي لمساحات Spaces — يقدم مساحات صور مفتوحة مثل «Flux Kolors Character» و«JanusFlow 1.3B».
2024-11-18|إعجابات 7 · إعادات نشر 0|https://bsky.app/profile/reach-vb.hf.co/post/3lb7slz2ycc2j
الإشارات
- تحديثات سريعة للنماذج المغلقة في النصف الأول من 2026: ظهرت GPT Image 2 من OpenAI وSeedance 2.0 من ByteDance وKling 3.0 وRunway Gen-4.5 وVidu Q3 بكثافة بين فبراير وأبريل. وأصبح تعدد اللقطات ومزامنة الصوت و4K/1080p مواصفات معيارية لنماذج الفيديو. وفي Bluesky، يمثل Replicate تقريبًا المصدر الأولي الوحيد.
- النشر حول المصادر المفتوحة في Bluesky متوقف عمليًا: توقف منشئو المحتوى الذين كانوا ينشرون ضبط LoRA لـFLUX/Flex/Wan2.1/HunyuanVideo، مثل ostris وdoctordiffusion، وحسابات Hugging Face الرسمية، في أواخر 2024 أو ربيع 2025. وفي المقابل، أكد بحث الويب وجود إصدارات فعلية في 2026 مثل Qwen-Image-2.1 (صدر في 9/20) وHunyuanImage 3.0 وZ-Image Turbo، لكن هذه الموضوعات غير مرئية تقريبًا في Bluesky.
- التفاعل عمومًا محدود: باستثناء حسابات تصل إلى جمهور تقني عام مثل Simon Willison، تتراوح الإعجابات بين رقم واحد وبضع عشرات. لا يبدو Bluesky مركزًا للمعلومات الأولية في هذا المجال؛ ويرجح أن تكون X وDiscord وHugging Face هي الساحة الرئيسة.
القيود
- أعاد
app.bsky.feed.searchPosts(API البحث الرسمي) HTTP 403 لكل الكلمات المفتاحية التي جُربت، بما فيها "image generation AI" و«nano banana»، لذلك لم يكن البحث بالكلمات ممكنًا. كما أن نسخة الويبbsky.app/searchتعمل بجافاسكربت ولم يتمكن WebFetch من جلب محتواها. استُبدل ذلك بطلبgetAuthorFeedفرديًا للحسابات المكتشفة عبر بحث الويب. - نتيجة ذلك، لا تمثل النتائج بحثًا شاملاً عبر الكلمات المفتاحية، بل تقتصر على منشورات الحسابات التي أمكن اكتشافها. ومن المرجح جدًا أن تكون حسابات ومنشورات بارزة أخرى قد فاتت.
- لم تُحل حسابات متوقعة مثل Black Forest Labs وfal.ai وStability AI وCivitai الرسمية في Bluesky (إما غير موجودة أو حسابات فارغة مثل
civitai.bsky.socialمع 19 متابعًا و0 منشور). - لم يُعثر على منشورات أولية في Bluesky لإصدارات الأوزان المفتوحة الرئيسة في 2026، مثل Qwen-Image-2.1 وHunyuanImage 3.0 وZ-Image Turbo.
- مقابل معيار تحليل نحو 20 منشورًا لكل شبكة، جُمعت نحو 30 مادة مرشحة من ستة حسابات، وقدمت 12 منها كاستنتاجات محددة. وبسبب تعذر استخدام API البحث، تقرر أن زيادة العدد على نحو موثوق أمر صعب.
Lemmy
Lemmy — أحدث اتجاهات توليد الصور والفيديو بالذكاء الاصطناعي
المجتمعات
- !«メールアドレス» (يظهر اتحاديًا أيضًا في lemmy.world) — 5.71K مشتركًا (894 محليًا). مساحة للحديث عن «تقنية توليد فن AI المفضلة»، وتتركز على موضوعات تقنية للنماذج المفتوحة الأوزان، مثل تكامل ComfyUI وروابط HF/GitHub للنماذج الجديدة. وهو الموطن العملي لهذا الموضوع في Lemmy.
- !«メールアドレス» — 2.36K مشتركًا (362 محليًا)، و3.55K منشورًا، و31 مستخدمًا نشطًا يوميًا/97 أسبوعيًا. مساحة لمشاركة الأعمال المنشأة عبر Stable Diffusion والنماذج المفتوحة الأوزان، مع منشورات شبه يومية.
- !share_anime_art (ضمن سلسلة stable_diffusion_art) — منشورات فن AI متخصصة بشخصيات الأنمي مثل Fate وIdolmaster وDisgaea.
- !stable_diffusion_abstract / !stable_diffusion_mycology (مجتمعات صغيرة ضمن سلسلة stable_diffusion_art) — يواصل المستخدم PapaSkwat توليد فن تجريدي وموضوعات فطرية عبر LoRA خاص دربه على لوحاته الزيتية والأكريليك، ويشغله محليًا على SDXL.
- !ai_reddit (المثيل غير معروف، ويبدو إعادة نشر تلقائية من r/ArtificialIntelligence) — تمر منه كمية كبيرة من أخبار الصناعة المغلقة، مثل إيقاف API لـSora وNano Banana وSeedance وVeo وKling، لكن درجاتها تقارب 0–1 ولا تحدث فيها محادثة فعلية تقريبًا.
- !hackernews (مجتمع مرآة لـHacker News) — تمر فيه أحيانًا روابط إعلانات رسمية مثل Qwen-Image-2.1 وSeedance 2.5.
- مرجع: !«メールアドレス» و!«メールアドレス» و!«メールアドレス» مجتمعات AI كذلك، لكنها ليست متخصصة في توليد الصور/الفيديو.
المنشورات
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — !stable_diffusion، درجة 13، 2026-09-22. إصدار جديد من نموذج صور مفتوح الأوزان بحجم 7B، ومخرج 2K أصلي، ودعم RGBA الشفاف، وتحرير باستخدام ما يصل إلى 10 صور. https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
- Qwen-Image-2.1: Compact, efficient, and unified image creation — !hackernews، درجة 2، 2026-09-20. إعلان Qwen الرسمي. https://qwen.ai/blog?id=qwen-image-2.1
- ComfyUI-Fantastic-MiniMaxH3-PromptBuilder / ComfyUI_MinimaxH3_AutoContext / comfyui-obvpm-timeline — !stable_diffusion، درجات 1 إلى 6، 2026-09-16 إلى 09-22. تتابع إضافة أدوات لتوليد الفيديو الطويل وإدارة المطالبات لـMiniMax H3 إلى منظومة ComfyUI.
- tencent/HunyuanVideo-I2V — !stable_diffusion، درجة 5. نموذج مفتوح المصدر لتحويل صورة إلى فيديو، مع نموذج FP8 وسير عمل تكامل مع ComfyUI. https://huggingface.co/tencent/HunyuanVideo-I2V
- I ran the same prompt through 6 AI video models and had ~40 people blindrank the results — !ai_reddit، درجة 1، 2026-09-17. تقييم انطباعي وضع Veo أولًا وSeedance 2.5 ثانيًا بفارق طفيف وHailuo أخيرًا بفارق كبير. https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !ai_reddit، درجة 1، 2026-09-20. خلاصة تقول إن المنتجات الاستهلاكية البراقة فشلت، بينما تجني المنتجات المؤسسية الهادئة مثل Synthesia وHeygen وKling وArgil المال. https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Seedance 2.5 إعلان رسمي — !hackernews، درجة 3، 2026-08-01. ميزات محسنة مثل فيديوهات 30 ثانية ودعم حتى 50 صورة مرجعية. https://seed.bytedance.com/en/blog/
- Google quietly discontinues its Earth AI feature a day after its rollout — !ai_reddit، درجة 1، 2026-08-07. سحبت Google ميزة دمج Nano Banana 2 في Google Earth خلال 24 ساعة بعد أن ولّد المستخدمون صور كوارث ونزاعات مزيفة في مواقع حقيقية. https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Nano Banana 2 Lite صفحة رسمية — !hackernews، درجة 1، 2026-06-30. بدأ تقديم نموذج توليد صور منخفض التكلفة بنحو 3 ينات للصورة. https://deepmind.google.com/models/gemini-image/flash-lite/
- Microsoft's MAI-Image-2.5 Pulls Even With Google's Nano Banana 2 on Benchmarks — !ai_reddit، درجة 1، 2026-05-28. صعد إلى المركز الثالث في لوحة Arena. https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/
- Midjourney pivots from AI image generation to body scanning medical spa / Midjourney Medical — !technology (درجة 58) / !hackernews / !techtakes (درجة 40)، 2026-06-18 إلى 19. خبر مفاجئ بأن Midjourney، الاسم المرتبط بتوليد الصور، تحول إلى أعمال ماسحات طبية «Ultrasonic CT». وفي الفترة نفسها ظهر خبر دعوى «Midjourney wants Hollywood studios to reveal AI usage» في !technology (درجة 73، 2026-07-05). https://www.theregister.com/ (Midjourney medical spa), https://techcrunch.com/ (Hollywood AI usage)
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — !ai_reddit، درجة 1، 2026-09-14. مقارنة تلوين آلي لصفحة مانغا بين ChatGPT Images 2.5 وWan 2.7 Pro وNano Banana Pro وSeedream 5.0 Pro، مع تقييم ChatGPT بأنه الأفضل في الحفاظ على الخطوط. https://www.reddit.com/gallery/1wfyqdy
إشارات
- Lemmy نفسه متحفظ تجاه الذكاء الاصطناعي: في منشور «Where are the AI user communities on Lemmy?» (lemmy.world/post/46457184)، جاء أعلى تعليق (36 صوتًا) بأن الأفضل النظر خارج Fediverse لأن Lemmy يميل إلى معاداة الذكاء الاصطناعي. ويبدو أن مستخدمي AI لا يجدون مساحة مريحة داخله، وأن الحاضنة الفعلية للمفتوح المصدر تتركز في مجتمعات !stable_diffusion على مثيل db0.
- الجانب المفتوح يركز على يوميات «الصنع والاستخدام»: تنشر !stable_diffusion في الأساس عقد ComfyUI وروابط نماذج Hugging Face ومعلومات تقنية، بينما تركز !stable_diffusion_art على مشاركة الأعمال اليومية (Krea2 turbo ونماذج Qwen وLoRA مخصصة وغيرها). درجات التفاعل في خانة الآحاد والعشرات، أي أن الحجم أصغر من Reddit لكن النشاط مستمر.
- أخبار المصدر المغلق أشبه بـ«واردات»: أخبار كبيرة مثل إيقاف API لـSora وNano Banana وSeedance وتحول Midjourney إلى معدات طبية لا تصل Lemmy إلا عبر إعادة نشر r/ArtificialInteligence من نمط !ai_reddit، وبدرجات 0–1 تقريبًا ودون نقاش محلي. لا يمكن متابعة هذا النوع من الأخبار اعتمادًا على Lemmy وحده.
- إجمالًا، تم التحقق من 12 ملاحظة في المنشورات أعلاه (6 تقريبًا مفتوحة و6 مغلقة). وبما أن ذلك بلغ الحد الأعلى لدليل العمل وهو 12، توقف الجمع عند هذا الحد.
القيود
- لم تستجب الاستعلامات المباشرة إلى API الرسمي لـLemmy (
/api/v3/community,/api/v3/post/list) سوى بأخطاء HTTP 400/500، لذا يعتمد الوصول المباشر إلى نصوص المنشورات وبعض أعداد المشتركين على معلومات مجزأة من بحث الويب والصفحات. - اختلطت نتائج كثيرة بأخبار سياسية واجتماعية غير مرتبطة بحسب كلمة البحث؛ إذ لم تنتج عمليات البحث المفردة مثل "Flux AI" و"Runway AI" و"Kling AI" نتائج، ولم يُعثر على أخبار مستقلة لـFlux من Black Forest Labs أوRunway داخل Lemmy.
- لم يُحدد اسم مثيل مجتمع !ai_reddit بدقة، لعدم ظهور تسمية المثيل في نتائج البحث.
- لم يتحقق بدقة معيار «تحليل نحو 20 منشورًا» بسبب انخفاض كثافة المنشورات في Lemmy. التزم الجمع بنطاق دليل العمل من 5 إلى 12 منشورًا، وبعد قراءة أكثر من 30 مرشحًا، استُبعد التكرار والضوضاء غير المرتبطة.
Pinterest — أخبار الذكاء الاصطناعي لتوليد الصور والفيديو
جُمعت 50 دبوسًا عبر بحث واحد («Image and Video Generation AI News»، بلا تقسيم حسب النوع). وفُتحت 20 صورة مباشرةً (المؤشرات 1–13 و16 و22 و25–26 و28 و31–33 و36 و38–39 و41–43 و45 و47–49) للتحقق مما تعرضه فعليًا، لأن معظم العناوين مقتضبة أو عامة.
الموضوعات البصرية
- صور مصغرة لـ«أخبار AI» بأسلوب YouTuber: رجل ملتحٍ بملامح صدمة أو اتساع عينين إلى جانب شبكة من شعارات شركات ثلاثية الأبعاد مضيئة (OpenAI وGoogle وMicrosoft وMeta وNotion). إطار نقرات بأسلوب MrBeast مطبق على ملخصات أخبار AI [1, 28].
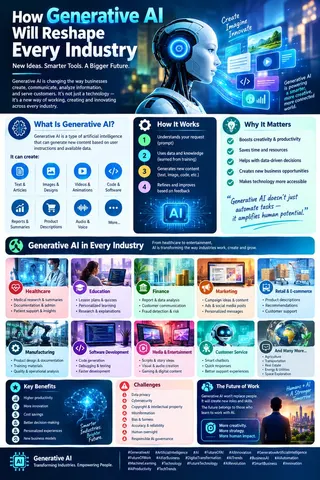
- لقطات قريبة لروبوت أو أندرويد أبيض بشري الهيئة بعيون زرقاء متوهجة، تستخدم كتمثيل عام للذكاء الاصطناعي في قصص غير مرتبطة تمامًا، من كشف الأخبار المزيفة وشرح الأخلاقيات إلى رسوم AI التوليدي للصناعة ورسم «أفضل مذيع أخبار AI» [3, 22, 41, 43, 48, 49].
- رسوم SaaS الإعلانية النيونية على خلفية كحلية: خلفيات داكنة زرقاء/سوداء وصناديق أيقونات بإطار وردي-بنفسجي-سماوي متوهج وخط عناوين عريض مكثف («6+ BEST AI VIDEO GENERATION WEBSITES»، «AI IMAGE VIDEO — BEST QUALITY VS BEST FREE»). وهو الشكل المسيطر لمحتوى «أي أداة ينبغي أن أستخدم؟» [4, 9, 39].
- شبكات شعارات الأدوات وقوائم المقارنة التي تسمي الأدوات المتكررة: Runway وPika وKling AI وLuma (Dream Machine) وCanva AI وHailuo AI للفيديو؛ وChatGPT/DALL·E وMidjourney وGemini وAdobe Firefly وRecraft وIdeogram وKrea للصور [4, 9, 39].
- صور القلق من «الأخبار المولدة بالذكاء الاصطناعي»: أشرطة بث واقعية («AI GENERATED»، وشريط سفلي بأسلوب NBC News) فوق مذيع/مراسِل اصطناعي واضح، وصورة ختم «FAKE» فوق روبوت يحمل هاتفًا. زاوية الثقة والتضليل متكررة بصريًا، لا نصيًا فقط [3, 32, 45, 48].
- صور مكبرة للدوائر والشرائح تتضمن كلمة «AI» متوهجة داخل السيليكون، وتستخدم كصور حوسبة/عتاد عامة لفكرة «الذكاء الاصطناعي موجود في كل مكان» [5].
- شبكات عرض نقل الأسلوب وحفظ الهوية: فيديو أو صورة مصدر واحدة يعاد إخراجها بأساليب «كتل خشبية» و«أوريغامي» و«ليغو» و«زهور» جنبًا إلى جنب؛ وهو نمط عرض لميزة منتج، هنا لقدرة قريبة من Luma لإعادة تصميم الفيديو [2].
- نمط الكولاج أو «جدار الصور المصغرة»: عشرات الإطارات الصغيرة لفيديوهات AI أو بطاقات قصيرة عمودية مجمعة في صورة طويلة واحدة، لترمز إلى حجم المحتوى المولد بالذكاء الاصطناعي الذي يغمر الخلاصات [31, 49].
دبابيس بارزة
- #1 — "AI News: Anthropic Leak Shows Us The Future of AI...": صيغة صورة رد فعل مصغرة تسمي Anthropic إلى جانب شعارات OpenAI/Google/Microsoft؛ توضح أن أخبار المختبرات المغلقة تُغلّف كدراما وتسريبات لجذب النقرات.
- #2 — "Google announces ultra-high quality video...": شبكة 3x5 تعيد تقديم فيديو مصدر واحد بأساليب كتل خشبية وأوريغامي وليغو وزهور؛ عرض ملموس لإعادة تصميم فيديو مع حفظ الهوية على نمط Nano Banana/Gemini، لا مجرد شريحة شعارات.
- #4 — "6+ Best AI Video Generation Websites": رسم معلوماتي يسمي Runway وPika وKling AI وLuma وCanva وHailuo بوصفها مجموعة أدوات الفيديو الافتراضية الحالية، مع إحصائية تقول إن 80% من المحتوى على الإنترنت بحلول 2026 سيتضمن فيديو.
- #9 — "AI Image Video: Best Quality vs Best Free": رسم شجرة قرار يفصل المدفوع (ChatGPT Plus وGemini Advanced وMidjourney وAdobe Firefly وRecraft وRunway Gen-3 وLuma وPika Pro وKaiber وSynthesia) عن المجاني (Ideogram وGemini Free وSeaArt وPlayground وKrea وCanva وInkscape وCapCut وPika Free وRunway Free)، وهو لقطة مفيدة لما يعده Pinterest حاليًا أدوات الصف الأول.
- #11 — "Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API": رسم قمع يجمع مدخلات الصورة والنص في دفق مخرجات واحد، بعلامة «Gemini API»؛ إذ يُسوّق توليد الفيديو المغلق مع الصوت كمنتج API للمطورين لا كتطبيق مستهلك فقط.
- #26 — "Google’s Gemini Omni Turns Anything Into Video": دبوس من وكالة تسويق خارجية (Osiz Technologies) يعيد تغليف إعلان قدرة Gemini «Omni»، ما يوضح أن أخبار النماذج المغلقة يعاد تحويلها فورًا إلى محتوى SEO وتوليد عملاء من شركات تطوير غير مرتبطة.
- #28 — "AI News: OpenAI Finally Released What We Asked For": من الصانع والصيغة نفسيهما في #1، لكن تركيزه هذه المرة على OpenAI؛ ما يؤكد أنها سلسلة متكررة لا حالة منفردة.
- #38 — "Amuse 3.0": صورة واقعية لصياد عجوز منسوبة إلى «صورة مولدة بالذكاء الاصطناعي أنشئت على AMD»؛ وهي من الدبابيس القليلة التي تربط توليد الصور بمورّد عتاد محدد وزاوية NPU على الجهاز بدل API سحابي.
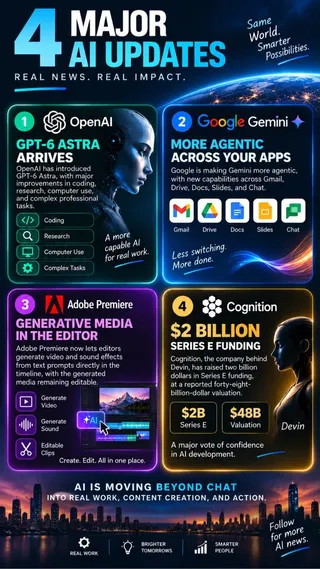
- #39 — "4 Major AI Updates": يسمي GPT-6 Astra وGemini الوكيلي عبر التطبيقات وAdobe Premiere للتوليد داخل الخط الزمني للفيديو/الصوت وجولة Cognition بقيمة $2B عند تقييم $48B؛ وهو أكثر ملخص أخبار مغلقة تحديدًا وحداثة في المجموعة.
- #45 — "AI Generated News Clip": مذيع اصطناعي مباشر موسوم في الصورة؛ أوضح إطار منفرد لفيديو AI يدخل إنتاج الأخبار والإعلام، ويكرر موضوع دبابيس #32 و#48 ذات أشرطة NBC News.
إشارات
- ما هو حاضر الآن: تهيمن نفس الأسماء المغلقة على مشهد Pinterest: Runway وPika وKling وLuma/Dream Machine وGoogle Gemini/Veo وOpenAI وAdobe Firefly/Premiere. لا تظهر تقريبًا نماذج مفتوحة مثل Stable Diffusion وFlux وHunyuanVideo وWan وLTX وComfyUI بالاسم. جمهور Pinterest لتوليد الصور AI يميل إلى محتوى «أي تطبيق مدفوع/مجاني أستخدم؟» وملخصات الأخبار التفاعلية، لا المناقشات التقنية على مستوى النموذج.
- تيار ثانوي قوي: محتوى القلق والثقة؛ أختام «FAKE»، ومذيعو الأخبار الاصطناعيون، ومقاطع بأسلوب NBC، ورسوم «هل يمكنك الوثوق بهذا الصوت؟» تكاد تتكرر بقدر محتوى مقارنة الأدوات. التأطير المتعلق بالتضليل والثقة الإعلامية نوع بصري أساسي هنا، لا هامشًا.
- غائب: لا أسماء نماذج مفتوحة أومستودعات، ولا علامة Hugging Face، ولا لقطات لسير عمل LoRA/الضبط الدقيق/ComfyUI، ولا مخططات مقاييس، وقليل جدًا عن أوراق أبحاث توليد الفيديو أو الاختراقات التقنية. نسخة Pinterest من الموضوع موجهة بالكامل تقريبًا للمستهلك والتسويق، لا للمطورين والهواة كما في Reddit أوX.
- عدة دبابيس محتوى SEO قديم أو دائم يعاد تدويره، مثل صور المخزون العامة لـ«توليد الصور بالذكاء الاصطناعي» وقائمة «أفضل مولدات فيديو AI» من 2025، لا أخبار الأسبوع. تمزج نتائج Pinterest التسويق المستمر بالأخبار المؤرخة، لذا يجب تقييم الحداثة دبوسًا بدبوس استنادًا إلى التواريخ أو أرقام الإصدارات الظاهرة مثل «GPT-6 Astra» و«Amuse 3.0».
القيود
- ينص دليل العمل للمرحلة على أن الصور جُمعت مسبقًا عبر عامل متصفح بلا واجهة؛ لم يُتصفح Pinterest مباشرةً، ولم يمكن البحث خارج ما في
pinterest.pins.md/images/pinterest/. - جاءت الدبابيس الخمسون كلها من استعلام مسطح واحد («Image and Video Generation AI News») بلا تقسيم نوعي، لذلك لا يمكن فصل الدبابيس إلى مغلقة ومفتوحة كما يتطلب هيكل الملخص؛ إذ إن مجموعة الصور نفسها لا تعرض أدوات أو مشاريع مفتوحة المصدر للإبلاغ عنها.
- فُتحت 20 من أصل 50 صورة مباشرة، ولم تفحص الثلاثون المتبقية واحدة واحدة؛ ومعظمها إدخالات صور مخزون عامة «(untitled)» في الجدول، وتشير عناوينها إلى أنها تكرر الأنماط البصرية نفسها.
- لا تكشف البيانات المجمعة مقاييس تفاعل الدبابيس، كالحفظ والتعليقات، لذا استُنتج «ما هو رائج» من التكرار البصري والموضوعي فقط، لا من إشارة شعبية كمية.
الإجراءات المقترحة
- الاستمرار في متابعة تحديثات مقاييس النماذج المفتوحة الصغيرة مثل Qwen-Image-2.1.
- التحقق من نصوص التراخيص قبل تصنيف النماذج التي تدعي أنها «مفتوحة المصدر».
- تضمين اتجاه الانتقال إلى الخدمات البديلة بعد إيقاف API لـSora في البحث القادم.
- إضافة عمليات بحث بأسماء مثل ComfyUI وHugging Face لتحسين ظهور النماذج المفتوحة في Bluesky وPinterest.
- إعادة جمع بيانات X باستخدام كلمات مفتاحية خاصة بالموضوع بدل الاعتماد على لوحة الاتجاهات.
الصور المجمعة
































ملاحظة حول جودة البيانات
لم تحقق أي من المنصات الست هدف الملخص المتمثل في نحو 20 عنصرًا لكل شبكة: لم يكن سوى 8 من 40 عنصرًا في X ملائمًا للموضوع لأن نقطة البحث كانت لوحة اتجاهات كرواتية؛ وتعذر استخدام API الكلمات المفتاحية في Bluesky بسبب 403، فاعتمد البحث على الحسابات المكتشفة؛ أما Pinterest فاعتمد استعلامًا واحدًا ولم يجمع أي مواد عن المصادر المفتوحة أصلًا.